

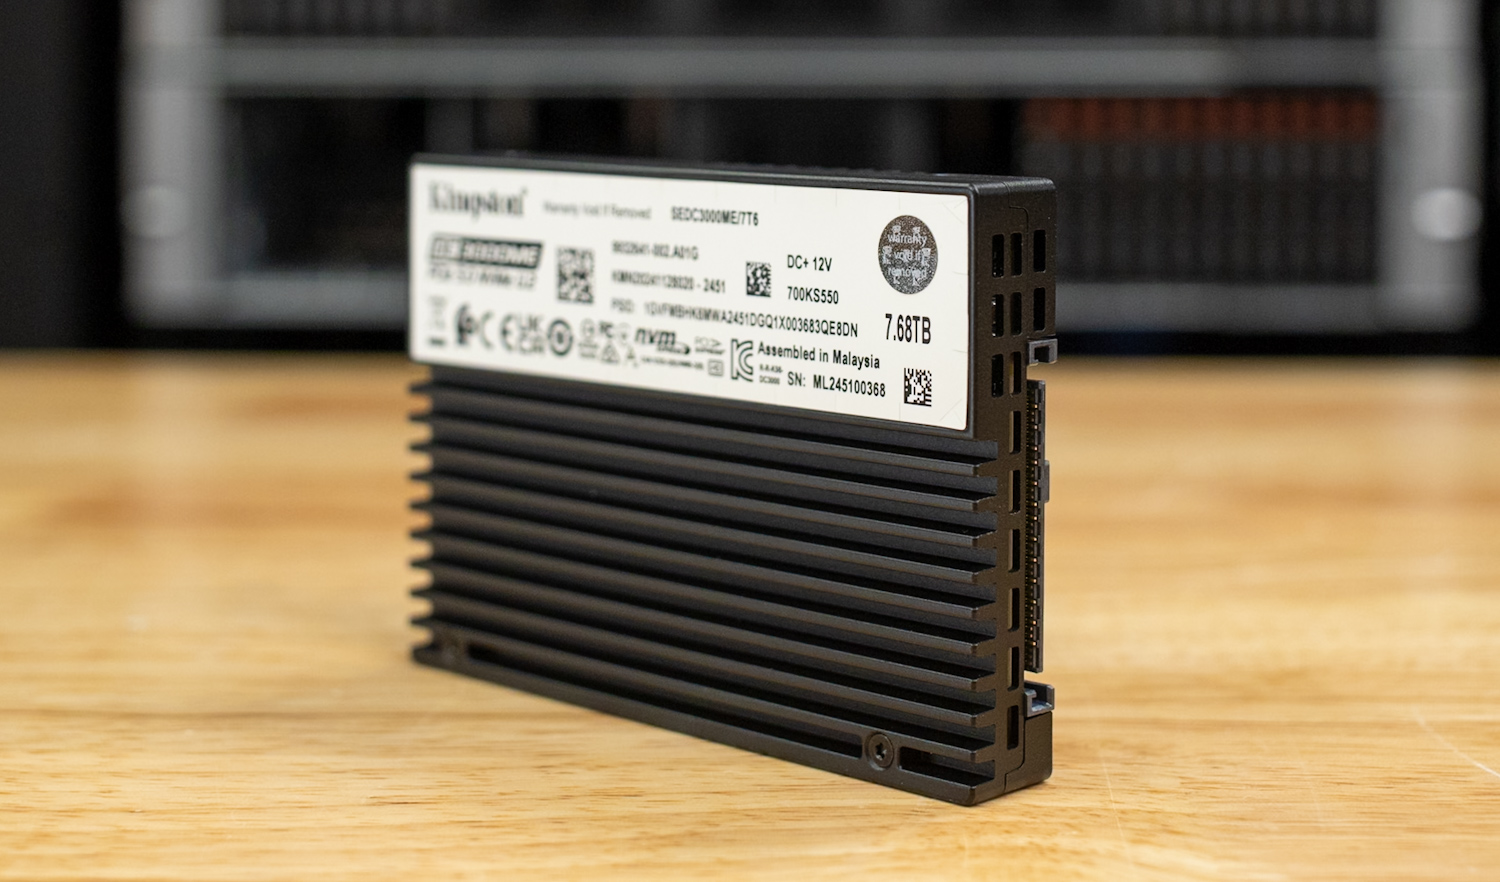
金士頓全新 DC3000ME 是該公司最新推出的企業級 NVMe SSD,採用 U.2 2.5 吋規格,專為資料中心和伺服器級工作負載而設計。它基於 PCIe 5.0 x4 接口,將高頻寬吞吐量與 3D eTLC NAND 結合,實現了強大的可靠性和容量擴展能力。此固態硬碟提供 3.84TB、7.68TB 和 15.36TB 三種容量配置,專為超大規模基礎設施、AI 和 HPC 叢集、雲端服務和交易系統等高需求環境而設計。
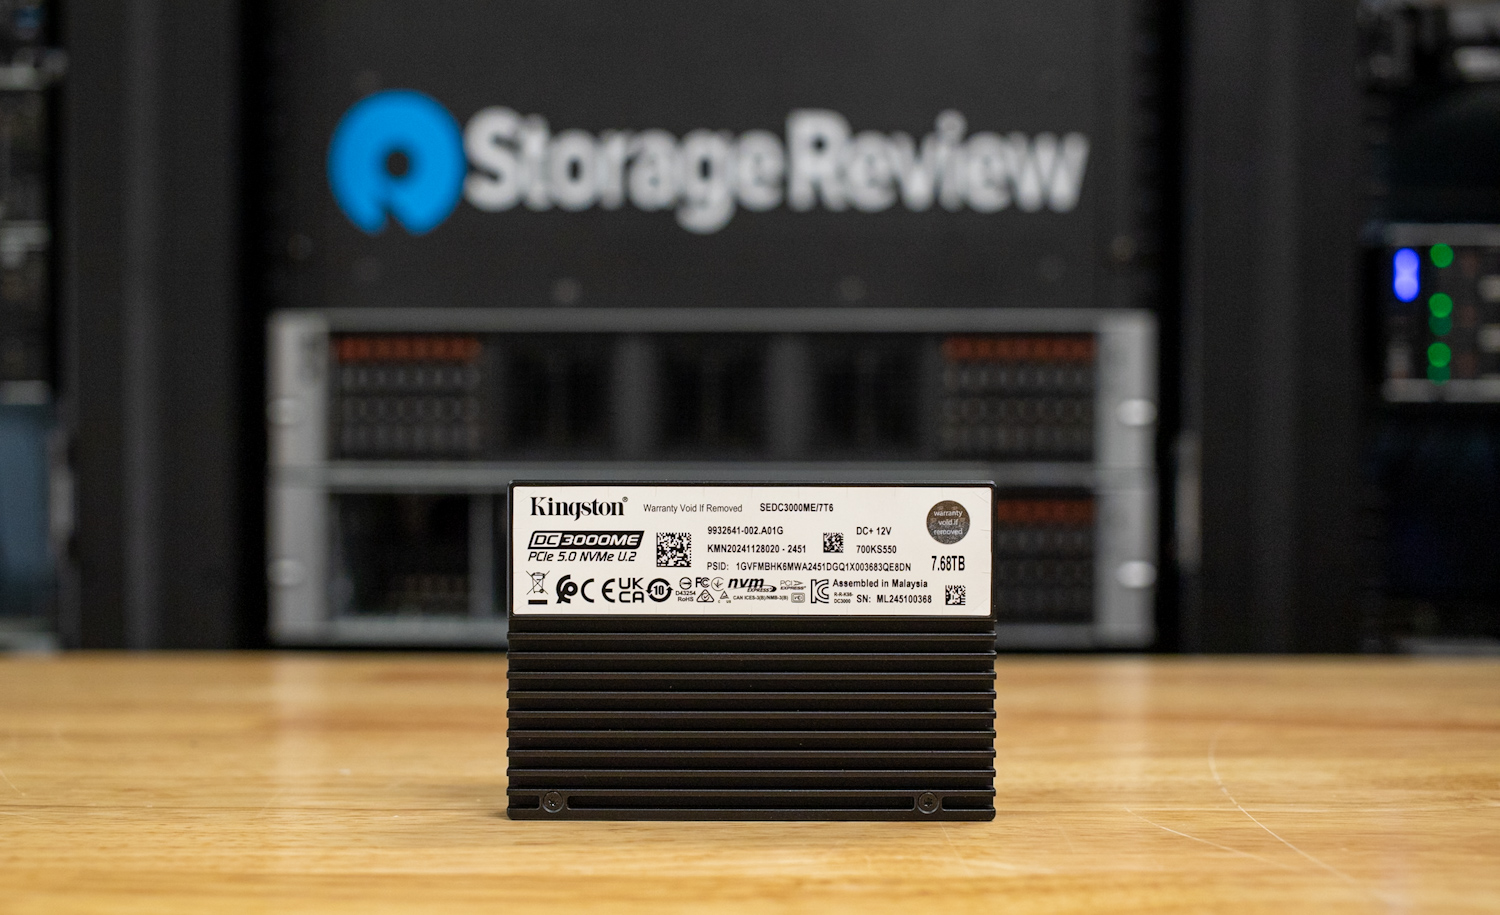
金士頓DC3000ME 效能簡介
DC3000ME 所有容量型號的順序讀取效能均相同,每個型號最高可達 14,000MB/s。無論選擇哪種容量,此速度對於高度依賴快速資料存取的工作負載而言都是理想之選。然而,順序寫入速度差異很大。 3.84TB 型號的速度限制為 5,800MB/s,而 7.68TB 型號則大幅提升至 10,000MB/s。 15.36TB 型號的速度略遜一籌,為 9,700MB/s。
從隨機效能來看,7.68TB 是所有硬碟中最快的,讀取速度最高可達 2.8 萬 IOPS,寫入速度最高可達 500,000 萬 IOPS。這超過了 3.84TB 和 15.36TB 的硬碟,後兩者的讀取速度上限均為 2.7 萬 IOPS。寫入速度方面,3.84TB 型號的寫入速度僅為 300,000 萬 IOPS,而 15.36TB 型號則達到了 400,000 萬 IOPS。 7.68TB 版本在處理繁忙、高需求任務方面能力最強。
從效能/容量角度來看,7.68TB 型號還提供了最均衡的吞吐量和 IOPS 組合,使其成為日誌記錄、OLTP 資料庫或主動 AI 模型訓練等寫入密集型應用程式的理想選擇。 3.84TB 型號可能更適合讀取密集或混合工作負載,這些工作負載對容量的要求不高;而 15.36TB 型號則以峰值寫入 IOPS 換取原始儲存密度。
金士頓DC3000ME 企業特色
DC3000ME 配備了一些在生產系統中至關重要的便利企業級功能。它內建斷電保護 (PLP),可在突發斷電時保護資料。此外,它還支援 AES-256 加密和 TCG Opal 加密,以確保靜態資料的安全。 DC3000ME 支援多達 128 個命名空間,這對於虛擬化或容器化用例特別有用。這種等級的命名空間支援與先進的 U.2 SSD 相當,對於大規模虛擬化環境尤其有用。金士頓還內建了遙測工具,用於追蹤硬碟的健康狀況、介質磨損和工作溫度,讓管理員能夠了解長期可靠性。
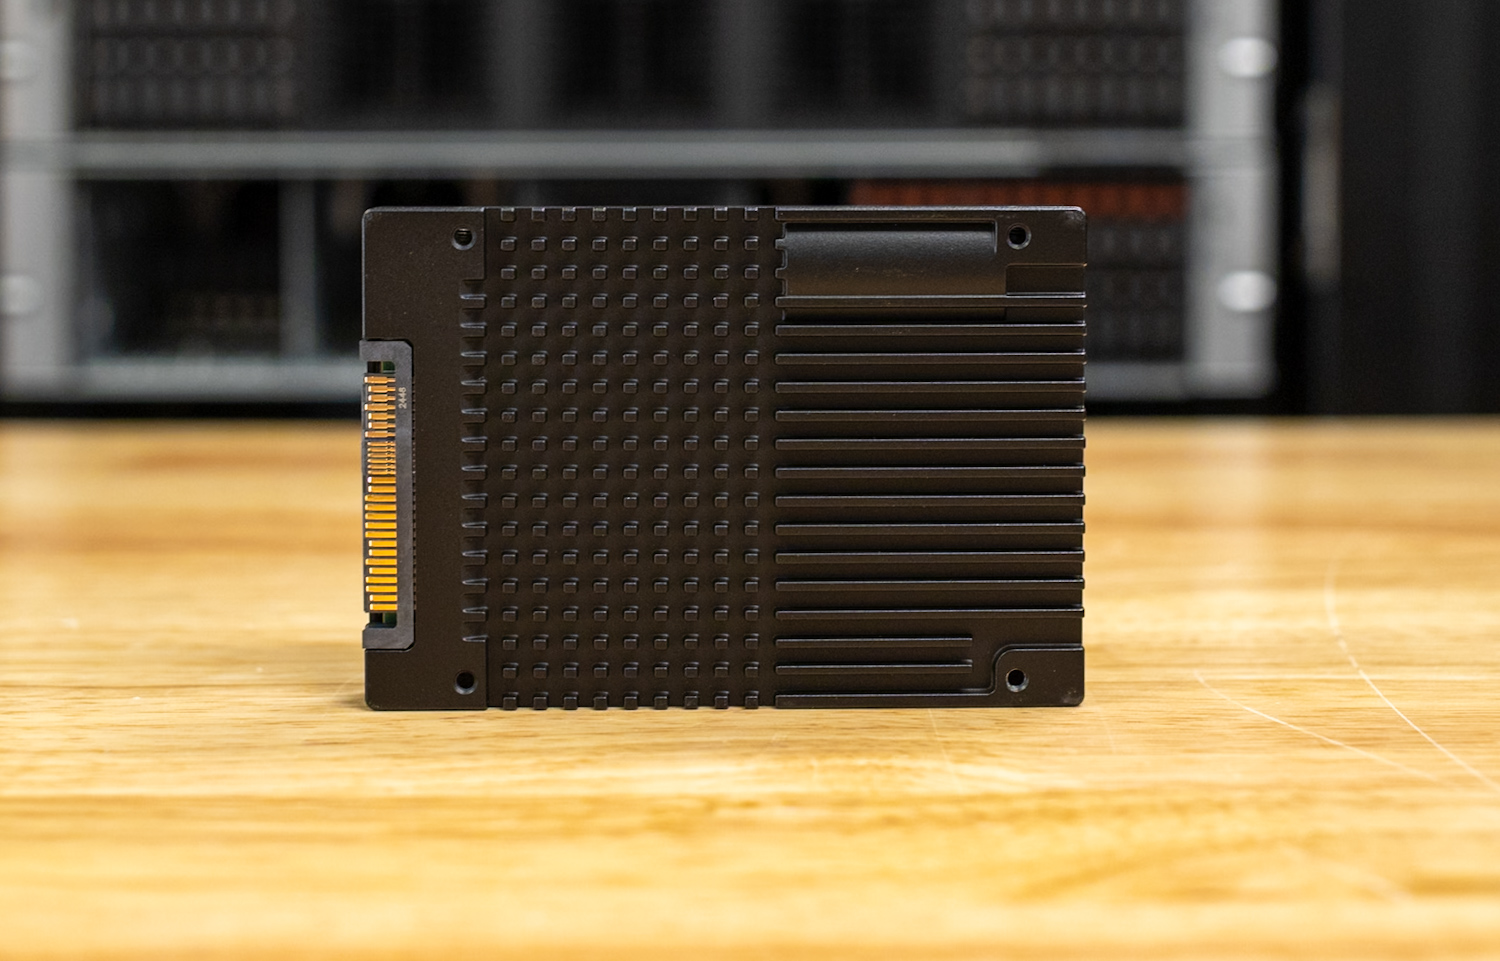
功耗範圍從空閒狀態下的 8W 到完整寫入期間的最高 24W,這似乎是高密度 U.2 SSD 在高負載下的典型值。金士頓指定的最大讀取功率為 8.2W,與空閒狀態下的數值非常接近,在讀取密集型工作負載下,功耗變化幅度較小。其耐用性等級符合您對企業級硬碟的預期,支援五年內每天進行一次完整寫入。這相當於 7,008 TBW 到 28,032 TBW 之間的數值,具體取決於容量。
Kingston DC3000ME 擁有兩百萬小時的 MTBF 評級和金士頓的五年有限保修,以及免費技術支援。
金士頓 DC3000ME 規格
| 規格 | 信息 |
| 外形 | U.2,2.5吋 x 15毫米 |
| 介面 | PCIe NVMe Gen5 x4(向後相容 Gen4) |
| 容量 | 3.84TB、7.68TB、15.36TB |
| NAND型 | 3D eTLC NAND |
| 順序讀/寫(MB/秒) | 3.84TB – 14,000 / 5,800 7.68TB – 14,000 / 10,000 15.36TB – 14,000 / 9,700 |
| 隨機讀/寫 IOPS (4K) | 3.84TB – 2,700,000 / 300,000 7.68TB – 2,800,000 / 500,000 15.36TB – 2,700,000 / 400,000 |
| 延遲QoS(99%) | 讀取:<10µs,寫入:<70µs |
| 靜態和動態磨損均衡 | 可以 |
| 電源丟失保護 | 是(電源容量) |
| 加密 | TCG Opal 2.0,AES 256 位元加密 |
| 命名空間管理 | 最多支援 128 個命名空間 |
| 企業診斷 | 遙測、介質磨損、溫度、健康狀況等。 |
| 耐久性(TBW/DWPD,5年) | 3.84TB – 7,008 TBW,1 DWPD 7.68TB – 14,016 TBW,1 DWPD 15.36TB – 28,032 TBW,1 DWPD |
| 電源消耗功率 | 空閒:8W,最大讀取:8.2W,最大寫入:24W |
| 工作溫度 | 0°C至70℃, |
| 尺寸 | 100.50mm x 69.8mm x 14.8mm |
| 重量 | 3.84TB – 146.2 克 7.68TB – 151.3 克 15.36TB – 152.3 克 |
| 振動(非工作) | 10G 峰值 (10–1000Hz) |
| 平均無故障時間 | 2萬小時 |
| 保固與支援 | 5 年有限保修和免費技術支持 |
金士頓DC3000ME性能測試
路測平台
在本次評測中,我們使用一台執行 Ubuntu 22.04.02 LTS 的戴爾 PowerEdge R760 伺服器作為所有工作負載的測試平台。該伺服器配備了Serial Cables Gen5 JBOF接口,可廣泛相容於 U.2、E1.S、E3.S 和 M.2 固態硬碟。我們的系統配置如下:
-
-
- 2 個英特爾至強金牌 6430(32 核,2.1GHz)
- 16 個 64GB DDR5-4400
- 480GB 戴爾 BOSS 固態硬碟
- 串行電纜 Gen5 JBOF
-
驅動器比較
CDN 效能
為了模擬真實的混合內容 CDN 工作負載,我們對 SSD 進行了多階段基準測試,旨在複製內容密集型邊緣伺服器的 I/O 模式。測試過程涵蓋了各種大小的區塊,包括大塊和小塊,分佈在隨機和順序操作中,並具有不同的並發等級。
在主要效能測試之前,每個SSD都使用100MB大小的區塊完成了1%順序寫入的全設備填充。此過程使用同步I/O和128的佇列深度,允許同時執行四個作業。此階段確保驅動器進入代表實際使用情況的穩定狀態。在順序填充之後,執行第二個三小時的隨機寫入飽和階段,使用加權區塊大小分割(區塊大小/百分比)分佈,其中98.51K傳輸量佔比最高(128%),其次是低於8K直至XNUMXK的區塊。此步驟模擬了分散式快取環境中常見的碎片化和不均勻的寫入模式。
主要測試套件著重於擴展的隨機讀寫操作,以測量驅動器在可變佇列深度和作業並發性下的行為。每次測試持續五分鐘(300秒),之後有三分鐘的空閒時間,以便內部恢復機制穩定性能指標。
- 使用固定區塊大小分佈執行,其中 128K(98.51%)為宜,其餘 1.49% 的操作由較小的傳輸大小組成,範圍從 64K 到 8K。每種配置分別包含 1、2 和 4 個並發作業,佇列深度分別為 1、2、4、8、16 和 32,以分析典型邊緣寫入條件下的吞吐量可擴充性和延遲。
- 我們採用了一個高度混合的區塊大小配置文件,模擬了 CDN 內容檢索,首先以 128K(83.21%)的佔比為主,然後是超過 30 個較小區塊大小的長尾,大小範圍從 4K 到 124K,每個區塊大小都具有不同的頻率表示。這種分佈反映了在視訊片段提取、縮圖存取和元資料查找過程中遇到的各種請求模式。這些測試也針對完整的作業數量和佇列深度矩陣進行了測試。
這種預處理、飽和度和混合大小隨機存取測試的組合旨在揭示 SSD 如何處理持續的類似 CDN 的環境,強調在頻寬密集和高度並行化場景中的響應能力和效率。
CDN 工作負載讀取 1
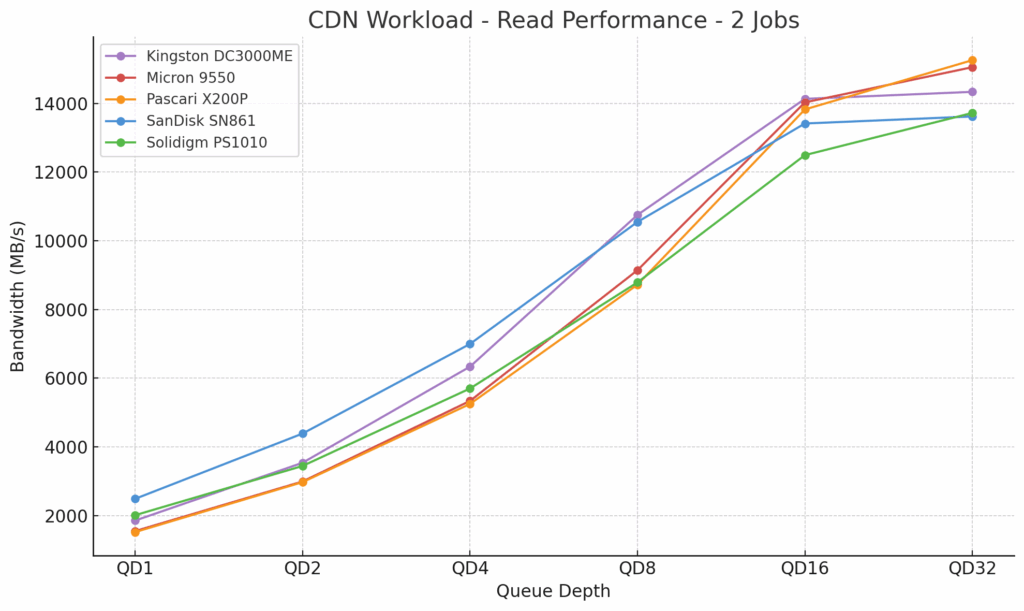
在我們的 CDN 工作負載讀取測試(1 個作業)中,金士頓 DC3000ME 表現出色,並能隨著佇列深度的增加而高效擴展。在隊列深度 1 時,它的速度達到了 940MB/s,落後於閃迪 SN861 約 26%。然而,隨著隊列深度的增加,DC3000ME 縮小了差距,並超越了幾個第五代固態硬碟。在隊列深度 5 時,金士頓 DC4ME 的速度達到了 3000MB/s,比美光 3,390 快約 42%,比 Pascari X9550P 快 40%,比 Solidigm PS200 快約 25%,儘管它略低於閃迪 SN1010 gm PS861 快約 2.6%,儘管它略低於閃迪 SN16 gm PS3000 9,645%。在 QD1010 測試中,DC13ME 的速度達到了 9550MB/s,比 Solidigm PS20 快了約 32%,比美光 14,131 快了約 9550%。在 QD1010 的最大測試深度下,金士頓的吞吐量達到了 15MB/s,與美光 861 相當,比 Solidigm PS10 快了約 XNUMX%,比 SanDisk SNXNUMX 快了近 XNUMX%。
 CDN 工作負載讀取 2
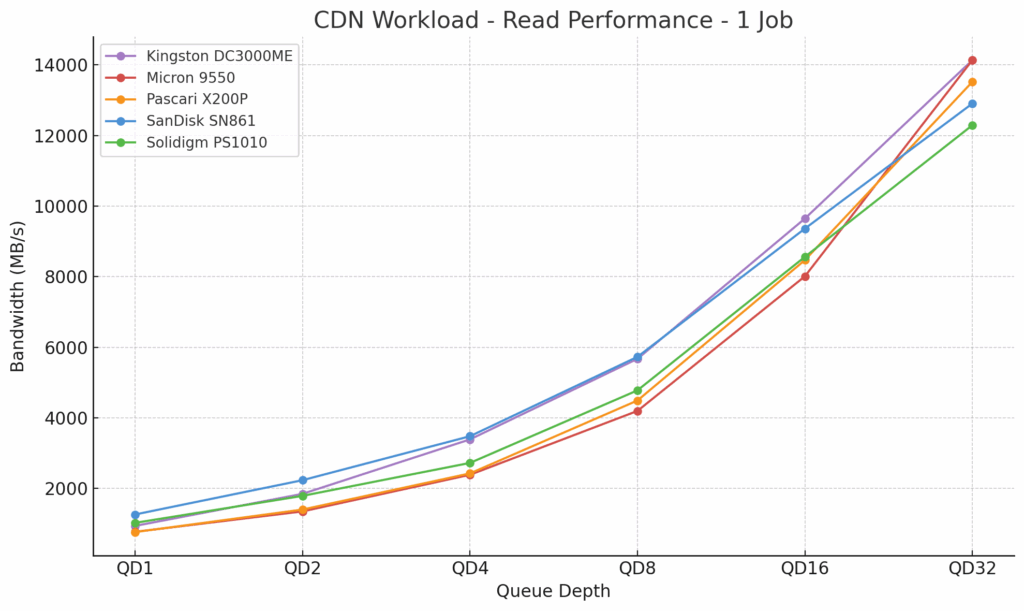 CDN 工作負載讀取 2
在雙任務 CDN 讀取工作負載中,金士頓 DC2ME 在所有佇列深度下再次保持強勁效能。在 QD3000 下,其速度達到 1MB/s。這比美光 1,854(9550MB/s)快 1,548%,比 Pascari X20P(200MB/s)快 1,519%,比 Solidigm PS22(1010MB/s)快約 2,011%,但比閃迪 SN8(861%)慢 2,487MB/s)。
在第 4 季度,金士頓的速度達到了 6,335MB/s,明顯優於美光(5,337MB/s)、Pascari(5,249MB/s)和 Solidigm(5,609MB/s)。然而,它仍然落後於 SanDisk,後者以 6,996MB/s 的速度位居榜首。
到 QD16 時,金士頓的速度達到了 14,131MB/s,目前處於領先地位。在最後一個測試點 QD32 時,它的速度略有提升,達到 14,336MB/s,分別落後 Pascari(15,257MB/s)和美光(15,052MB/s)約 6% 和 5%,但仍然穩固領先於 SanDisk(13,619MB/s)和 13,721%,但仍然穩固領先於 SanDisk(XNUMXMB/s)和 Solgms(XNUMX)。
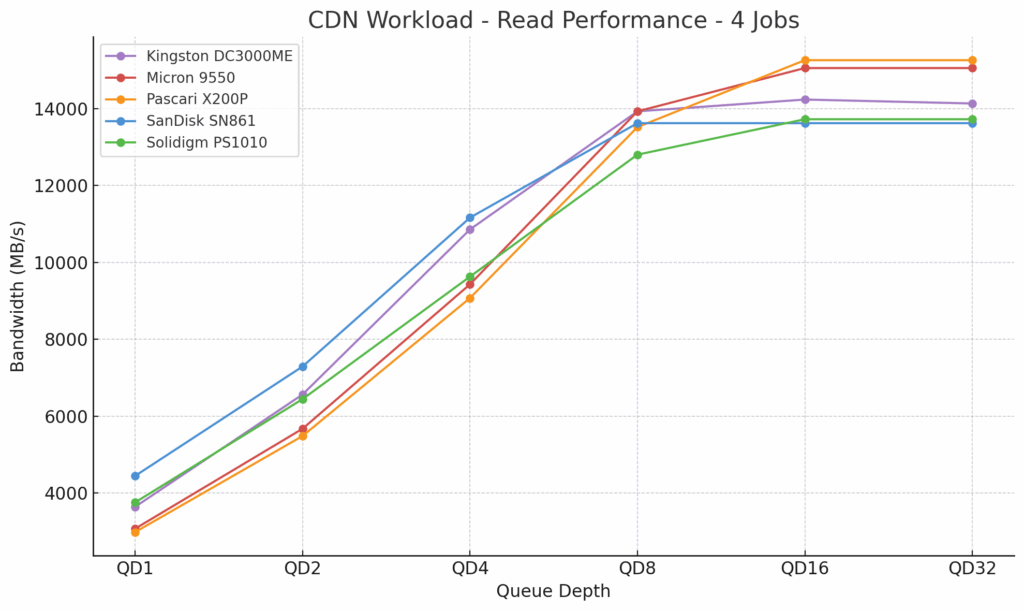
CDN 工作負載讀取 4
在四項任務同時運行的情況下,金士頓 DC3000ME 在 CDN 讀取效能方面繼續保持領先地位。在 QD1 時,它達到了 3,639MB/s,超過了美光 9550(3,070MB/s)和 Pascari X200P(2,982MB/s),但仍比 SanDisk SN22 慢 861%,後者以 4,443MB/s 的速度領先同級。到 QD4 時,金士頓達到了 10,854MB/s,比美光(15MB/s)提高了 9,427%,比 Pascari(20MB/s)高出 9,070%,略高於 Solidigm(9,627MB/s)。然而,它仍然落後於 SanDisk 的 11,161MB/s。
到第 8 季度,金士頓的吞吐量達到 13,926MB/s,幾乎與美光持平,與閃迪(13,619MB/s)和 Solidigm(12,800MB/s)大致持平。在 QD16 和 QD32 季度,金士頓的吞吐量穩定在 14,131-14,233MB/s 左右,略低於美光和 Pascari(兩者均在 15,052-15,257MB/s 左右),但仍遠超閃迪(13,619MB/s)和 Solsgm(MBcgm)。
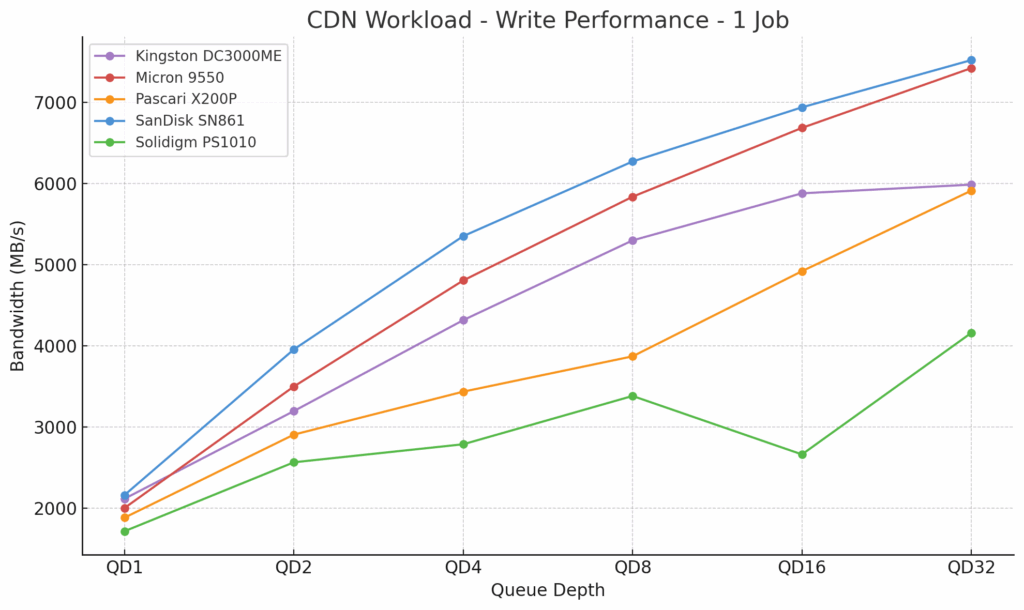
CDN 工作負載寫入 1
在我們的 CDN 寫入工作負載(1 個作業)中,金士頓 DC3000ME 在不同佇列深度下均表現出一致的擴展性。在 QD1 時,它的速度達到了 2,118MB/s,快於美光 9550(2,004MB/s)、Pascari X200P(1,885MB/s)和 Solidigm PS1010(1,718MB/s),但僅略微落後於閃迪 SNgm PS861(2,164MB/s),但僅略微落後於閃迪 SNgm PS4(4,318MB/s),但僅略微落後於閃迪 (SNgm PS55MB)。在 QD2,789 時,金士頓的速度達到了 26MB/s,比 Solidigm(3,437MB/s)快 10%,比 Pascari(4,807MB/s)快 19%,但比美光(5,353MB/s)慢 XNUMX%,比閃迪(XNUMX%)。
到了第 16 季度,它的速度達到 5,880MB/s,比 Pascari(4,921MB/s)高出 20%,比 Solidigm(2,664MB/s)高出一倍多,但仍落後美光(11MB/s)6,686%,比 SanDisk(15%)。到第 6,939 季度,金士頓的速度達到 32MB/s,再次接近 Pascari(5,987MB/s),但落後美光(5,913MB/s)和 SanDisk(7,422MB/s)約 7,521% 和 20%。
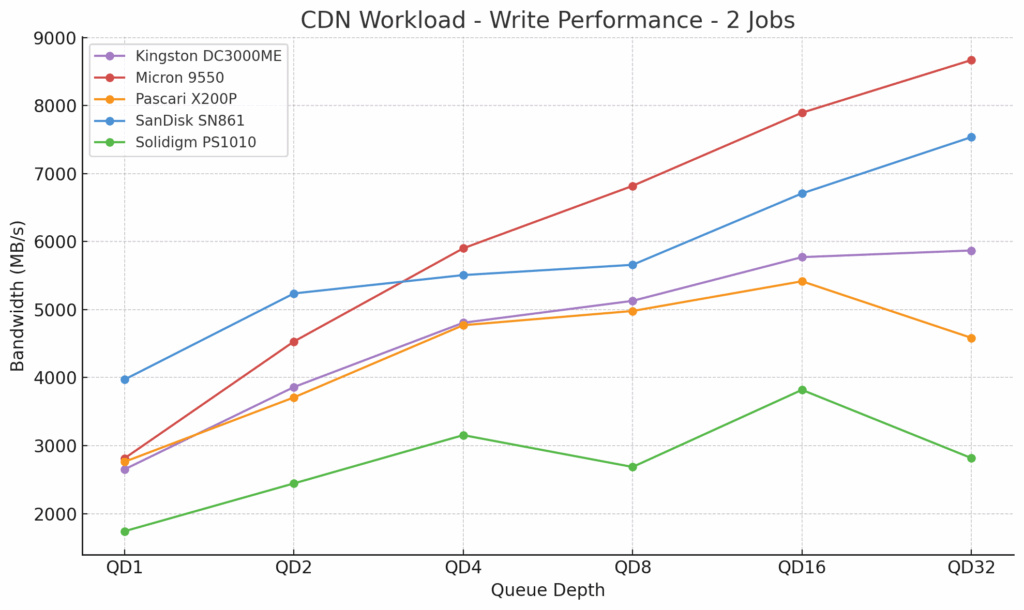
CDN 工作負載寫入 2
在雙任務 CDN 寫入工作負載中,金士頓 DC2ME 表現出了穩定的效能,儘管它總體上落後於速度最快的第五代企業級 SSD。在 QD3000 測試中,它的速度為 5MB/s,略低於美光 1(2,651MB/s)和 Pascari X9550P(2,813MB/s),比閃迪 SN200(2,762MB/s)慢了約 33%。
隨著佇列深度的增加,DC3000ME 也保持了同步。在 QD4 時,它的速度達到了 4,807MB/s,比美光 23(9550MB/s)慢了約 5,902%,比 SanDisk SN13(861MB/s)慢了 5,508%,但領先於 Solidigm PS1010(3,154MB/MB)。
在 QD16 時,金士頓的傳輸速度為 5,772MB/s,仍落後於美光 (7,896MB/s) 和閃迪 (6,709MB/s),但繼續優於 Solidigm PS1010 (3,820MB/s) 和 Pascari X200P (5,417/MB/MBs)。在 QD32 時,DC3000ME 的峰值速度達到 5,870MB/s,比美光 32 (9550MB/s) 慢 8,670%,比閃迪 SN22 (861MB/s) 慢 7,537%,但仍領先於 Solidi1010 (2,817)。
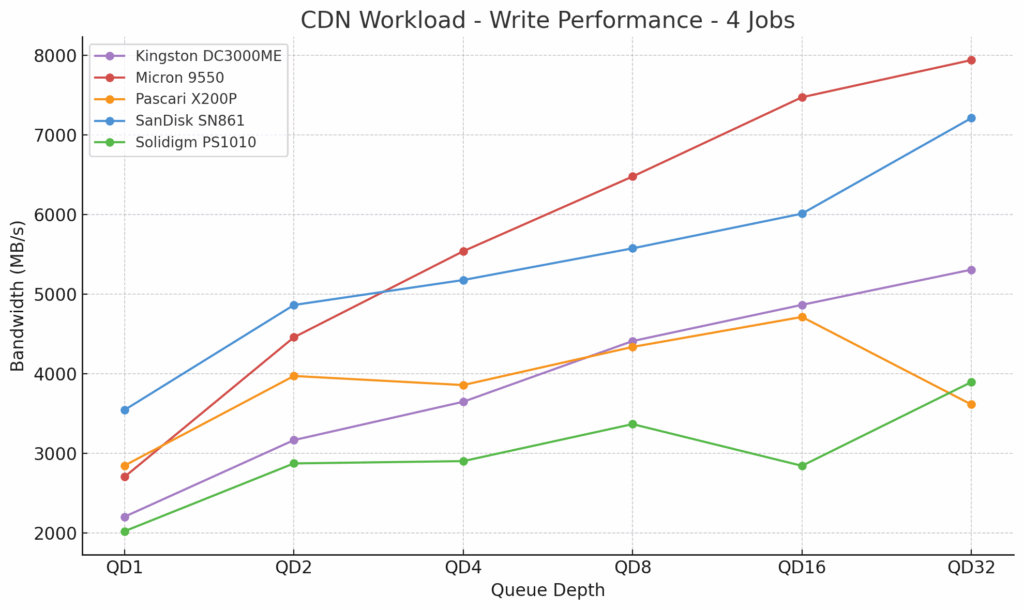
CDN 工作負載寫入 4
在四任務 CDN 寫入工作負載中,金士頓 DC4ME 在所有隊列深度上都表現穩定,儘管總體上落後於排名前兩位的第五代硬碟。在 QD3000 時,它達到了 5MB/s,落後於 Pascari X1P(2,202MB/s)、美光 200(2,845MB/s)和閃迪 SN9550(2,703MB/s),但領先於 Solidigm861(3,544(1010(2,020(2)(單位)。在 QD3,165 時,金士頓達到了 4,863MB/s,再次落後於閃迪(4,457MB/s)和美光(2,872MB/s),但仍領先於 Solidigm(XNUMXMB/s)。
在中等隊列深度下,金士頓 DC3000ME 在 QD3,647 時達到了 4MB/s,在 QD4,410 時達到了 8MB/s。雖然這顯示出不錯的擴展性,但在兩個測試點上,它仍然落後於美光硬碟(5,539MB/s 和 6,478MB/s)和閃迪硬碟(5,177MB/s 和 5,575MB/s)。在 QD16 時,金士頓達到了 4,865MB/s,比 QD8 略有提升,但仍然落後於閃迪硬碟(6,011MB/s)和美光硬碟(7,474MB/s)。在 QD32 時,DC3000ME 達到了 5,307MB/s 的峰值,遠遠領先於 Solidigm(3,894MB/s),但明顯落後於美光(7,941MB/s)和閃迪(7,212MB/s)。儘管金士頓硬碟並非效能領先者,但它保持了一致的擴展性和效率。
DLIO 檢查點基準
為了評估固態硬碟 (SSD) 在 AI 訓練環境中的實際效能,我們使用了資料和學習輸入/輸出 (DLIO) 基準測試工具。 DLIO 由阿貢國家實驗室開發,專門用於測試深度學習工作負載中的 I/O 模式。它能夠深入了解儲存系統如何應對檢查點設定、資料提取和模型訓練等挑戰。下圖展示了兩款固態硬碟如何在 36 個檢查點上執行整個過程。在訓練機器學習模型時,檢查點對於定期保存模型狀態至關重要,可防止中斷或斷電期間進度遺失。這種儲存需求需要強大的效能,尤其是在持續或密集的工作負載下。我們使用了 2.0 年 13 月 2024 日發布的 DLIO 基準測試 XNUMX 版。
為了確保基準測試能夠反映真實場景,我們基於 LLAMA 3.1 405B 模型架構進行測試。我們使用 torch.save() 實作了檢查點,以擷取模型參數、最佳化器狀態和層狀態。我們的設定模擬了一個八 GPU 系統,實現了混合平行策略,其中四路張量並行和雙向管線平行處理分佈在八個 GPU 上。此配置的檢查點大小為 4GB,代表了現代大型語言模型的訓練需求。
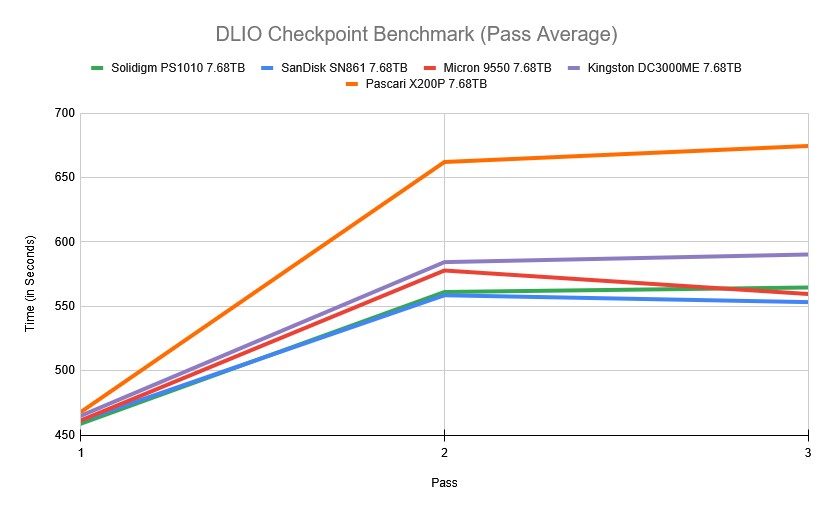
在 DLIO 平均測試結果中,金士頓 DC3000ME 7.68TB 略遜於頂級競爭對手,在五款硬碟中處於中等水平。第一次測試的平均時間為 465.04 秒,第二次測試為 584.38 秒,第三次測試為 590.30 秒。雖然金士頓 DC200ME 的速度始終快於 Pascari X7.68P 674.48TB(後者在三次測試中均創下了最高記錄,第三次測試中達到 3 秒),但仍落後於美光 3000 9550TB 和 Solidigm PS7.68 1010 秒,最後一次。
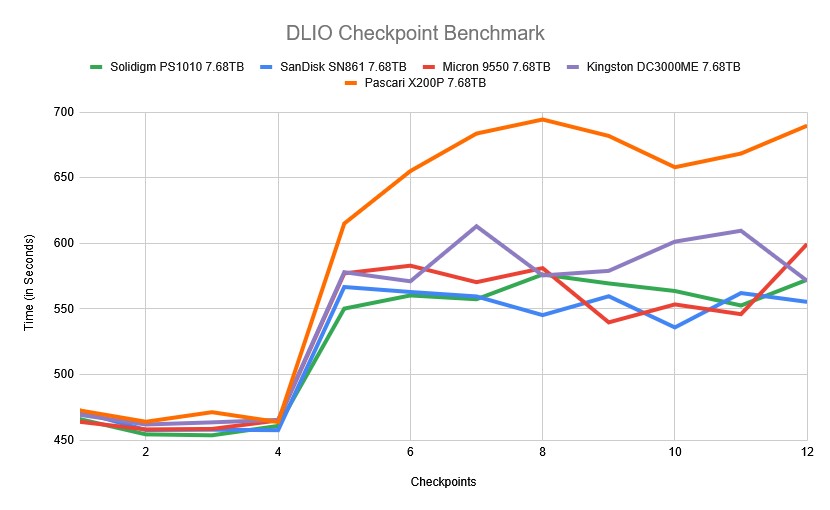
如下圖所示,金士頓 DC3000ME 開局強勁,早期測試點的成績與頂級競爭對手不相上下。在測試點 1,它的成績為 469.27 秒,略低於美光 9550 的 464.01 秒,並領先於 Pascari X200P 的 472.65 秒。從測試點 2 到 4,它的成績穩定在 461.92 秒到 465.44 秒之間,同樣接近美光 9550 和 Solidigm PS1010,這兩款處理器的成績都在 453 到 465 秒之間徘徊。
測試進行到中段(檢查點 5 至 8),金士頓 DC3000ME 的檢查點時間出現跳躍式增長,在第 613.01 個檢查點達到峰值 7 秒。這一成績高於美光 9550(570.42 秒)和閃迪 SN861 7.68TB(559.56 秒),但仍明顯優於 Pascari X200P,後者在同一時間段內的最高成績為 694.38 秒。測試接近尾聲時,金士頓 DC3000ME 略微穩定下來,在第 571.36 個檢查點的成績為 12 秒,比美光 28 慢了大約 9550 秒,但仍然快於 Pascari X200P,後者的成績為 689.68 秒。總體而言,金士頓 DC3000ME 7.68TB 表現出了穩定的性能,並在整個檢查點工作負載中保持在競爭範圍內,處於中等水平。
FIO性能基準
為了衡量每個 SSD 在常見產業指標上的儲存效能,我們利用 FIO。每個 SSD 都經過相同的測試流程,其中包括一個預處理步驟:使用順序寫入工作負載兩次全盤填充,然後測量穩態效能。隨著被測工作負載類型的變化,我們會再次執行一次基於新傳輸大小的預處理填充。
在本節中,我們將重點放在以下 FIO 基準:
- 128K 連續
- 64K隨機
- 16K隨機
- 4K隨機
由於高容量 QLC SSD 專為大傳輸尺寸而設計,我們的寫入速度測試僅限於 16K 隨機資料。對於 4K 數據,我們利用 16K 工作負載的預填充狀態來僅測量 4K 隨機讀取效能。
128K 順序前提條件 (IODepth 256 / NumJobs 1)
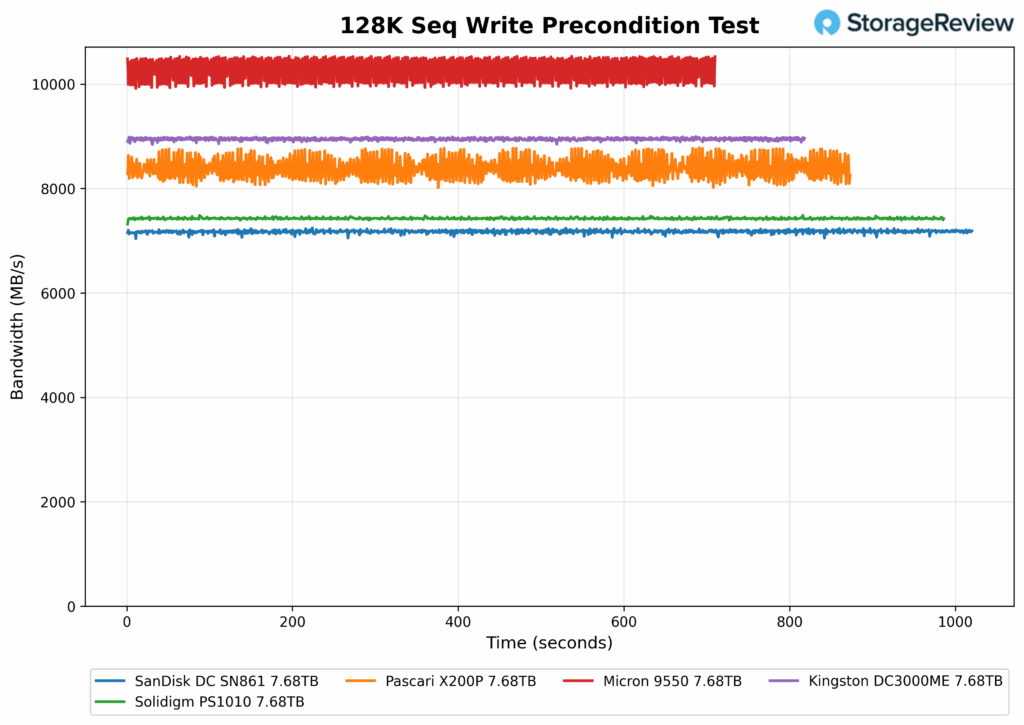
在這項高隊列深度預處理測試中,金士頓 DC3000ME 在 8,944.9 秒的運行過程中保持了 1,000MB/s 的穩定寫入頻寬(儘管測試剛過 800 秒就結束了)。雖然速度並非最快(略遜於美光 9550,後者的峰值達到了 10.3GB/s),但金士頓 DC3000ME 表現出了穩定的吞吐量,且波動很小。
128K 順序預處理延遲 (IODepth 256 / NumJobs 1)
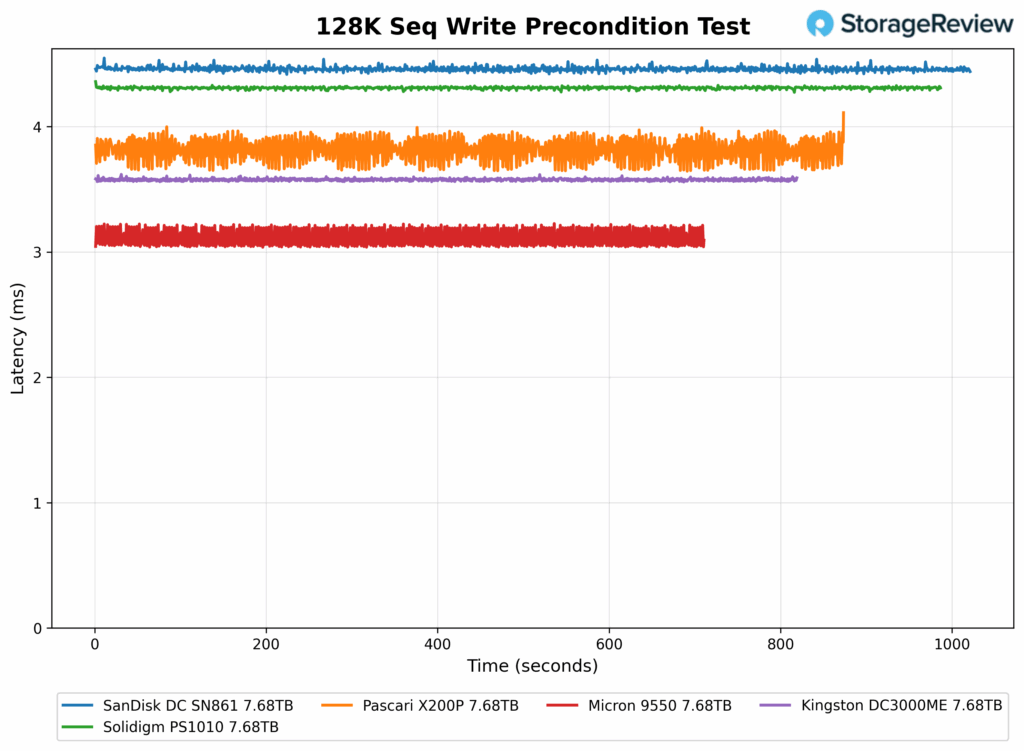
在 128K 順序寫入預設延遲測試中,金士頓 DC3000ME 的平均延遲為 3.577 毫秒(隨時間保持穩定,波動最小),僅次於美光硬碟。
128K 順序寫入(IODepth 16/NumJobs 1)
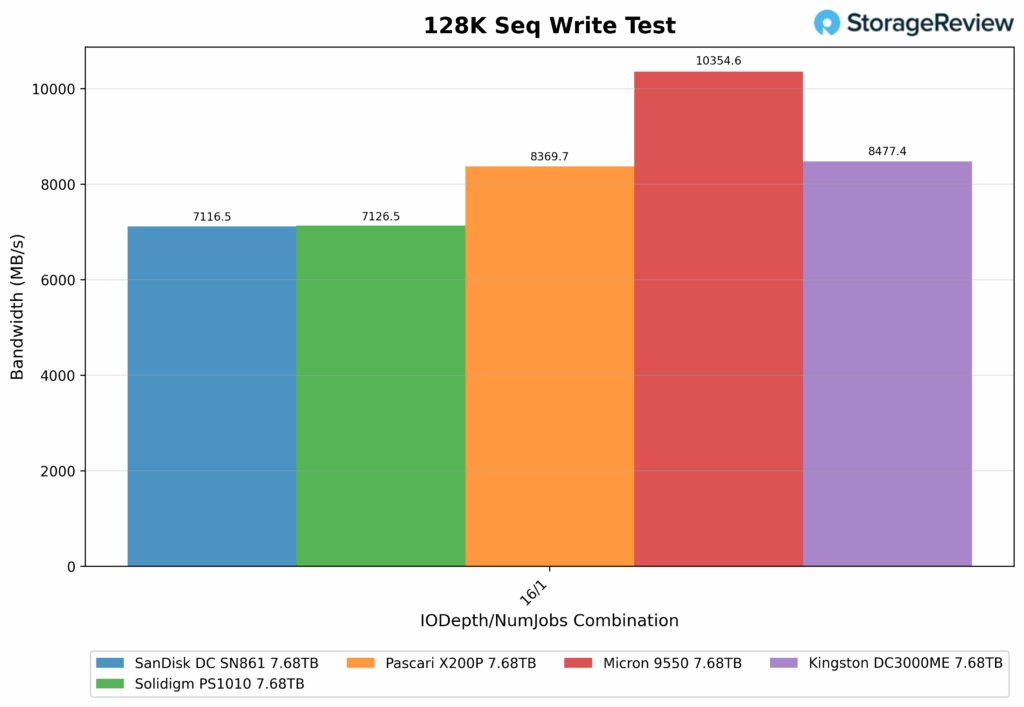
在 128K 順序寫入測試中,金士頓 DC3000ME 的速度達到了 8,477.4MB/s,略低於美光 9550,後者的速度為 10,354.6MB/s,位居榜首。金士頓 DC3000ME 的表現優於 Pascari X200P,並穩固領先 Solidigm PS1010 和閃迪 SN861,後者的速度均在 7,100MB/s 左右。金士頓的表現體現了速度與穩定性之間的良好平衡。
128K 順序寫入延遲 (IODepth 16 / NumJobs 1)
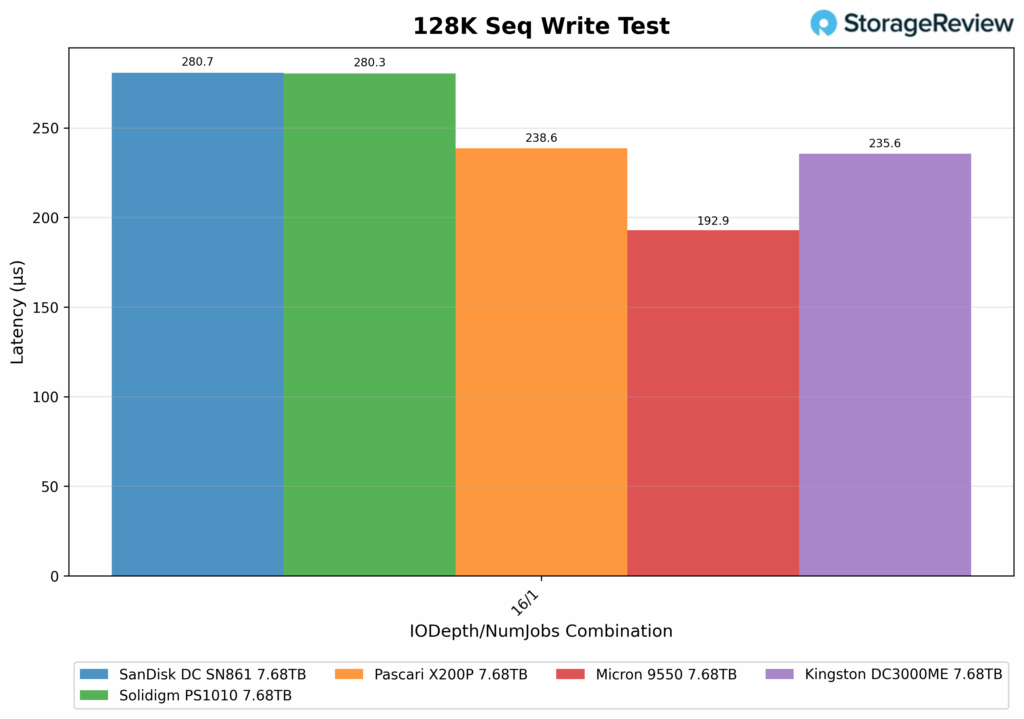
在 128K 順序寫入延遲測試中,金士頓 DC3000ME 表現出色,平均延遲為 235.6µs。這使其領先於閃迪 SN861 和 Solidigm PS1010,後兩者的延遲分別為 280.7µs 和 280.3µs。雖然速度不如美光 9550(延遲為 192.9µs),但金士頓 DC3000ME 仍保持競爭力,並且略勝 Pascari X200P(延遲為 238.6µs)。
128K 順序讀取(IODepth 64 / NumJobs 1)
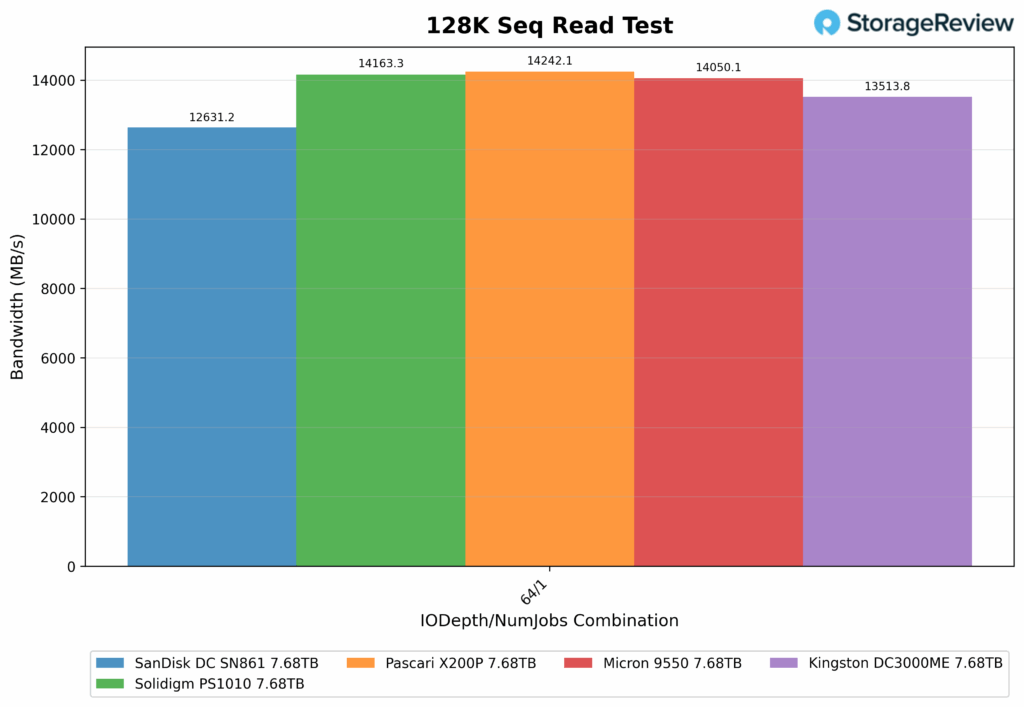
在佇列深度為 128 的 64K 順序讀取測試中,單任務執行速度達到 3000MB/s。雖然這在測試的硬碟中排名第四,但它仍然提供了強勁的吞吐量(實際差異很小)。它落後於 Pascari X13,513.8P(200MB/s)約 14,242.1%,落後於 Solidigm PS5.1(1010MB/s)約 14,163.3%,落後 Micron 4.6(9550MB/s)約 14,050.1%。它也輕鬆超越了 SanDisk SN3.8,後者的速度較低,僅為 861MB/s。儘管如此,金士頓 DC12,631.2ME 的成績仍然強勁,與測試中的頂級硬碟相比,差距很小。
128K 順序讀取延遲 (IODepth 64 / NumJobs 1)
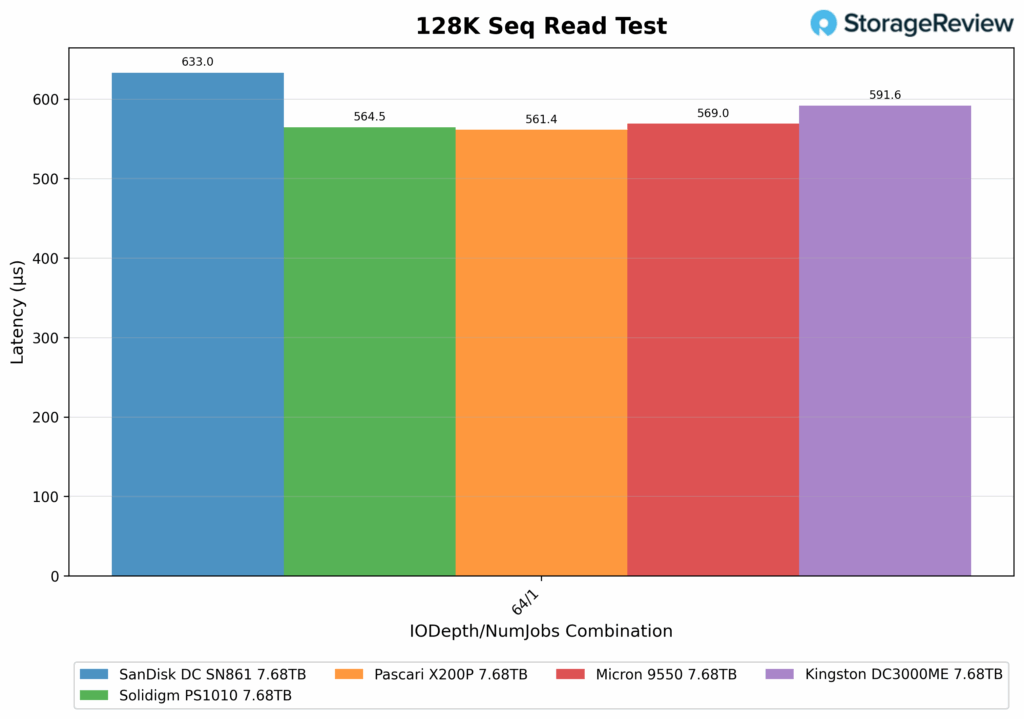
延遲方面,金士頓 DC3000ME 的平均延遲為 591.6µs,處於中等水平。此結果比美光 5.4(9550µs)高 569.0%,比 Solidigm PS5.4(1010µs)低 564.5%。 Pascari X200P 以 561.4µs 的延遲略微領先,而閃迪 SN861 的反應速度最慢,為 633.0µs。最終,金士頓 DC3000ME 在高隊列深度讀取條件下保持了相對較低的延遲。
64K 隨機寫入
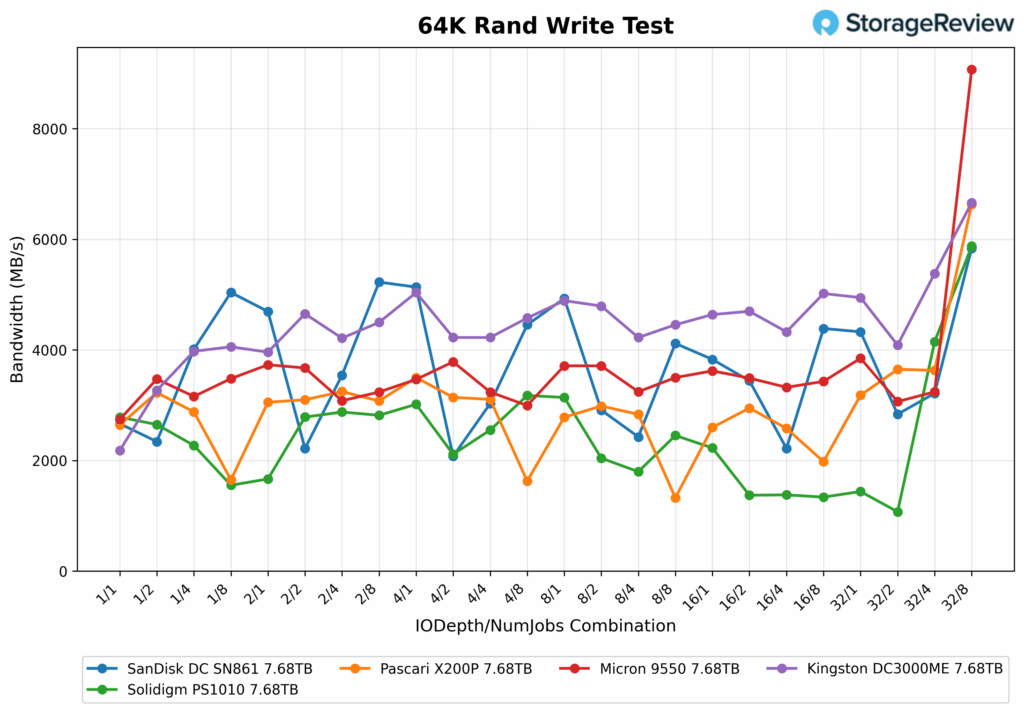
在 64K 隨機寫入測試中,金士頓 DC3000ME 在各種佇列深度和執行緒組合下始終保持高效能,在 6,649(IO 深度)/32(作業數)配置下峰值達到 8MB/s。這一成績在所有工作負荷和測試點中名列前茅。
綜觀整個圖表,金士頓 DC3000ME 的頻寬趨勢在 4,000 至 5,000MB/s 之間保持穩定,在中高並發設定下表現尤為強勁,例如 32/4(5,380MB/s)和 16/8(5,017MB/s)。即使在 1/4 和 2/4 等較輕的條件下,其頻寬也保持在 4200MB/s 以上。與其他硬碟相比,金士頓 DC3000ME 在大多數測試點上通常處於領先或接近領先水平,在整個測試過程中既提供了高峰值吞吐量,又提供了穩定的性能。
64K隨機寫入延遲
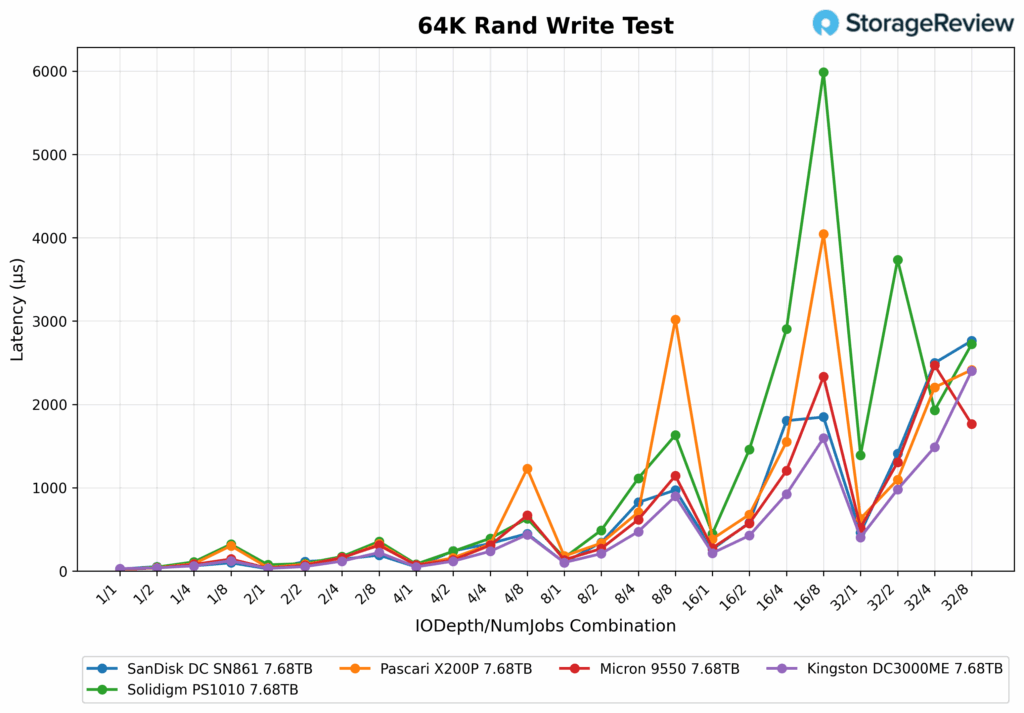
在 64K 隨機寫入延遲測試中,金士頓 DC3000ME 在大多數佇列深度和作業組合下始終保持較低的回應時間,即使在高負載下也展現出強大的寫入效率。例如:
- 在 4/1 時,顯示 49µs
- 在 8/1 時,延遲保持在 102µs 的低位
- 在 16/4 時,測量時間為 1,486µs
- 在最高測試負載 32/8 下,它達到了 2,402µs
這些結果表明,金士頓 DC3000ME 的擴展性可預測,避免了其他驅動器中出現的嚴重延遲峰值,尤其是 Pascari 和 Solidigm 驅動器,它們在 3,000–6,000µs 以上表現出不穩定的跳躍(最明顯的是 16/8)。
64K 隨機讀取
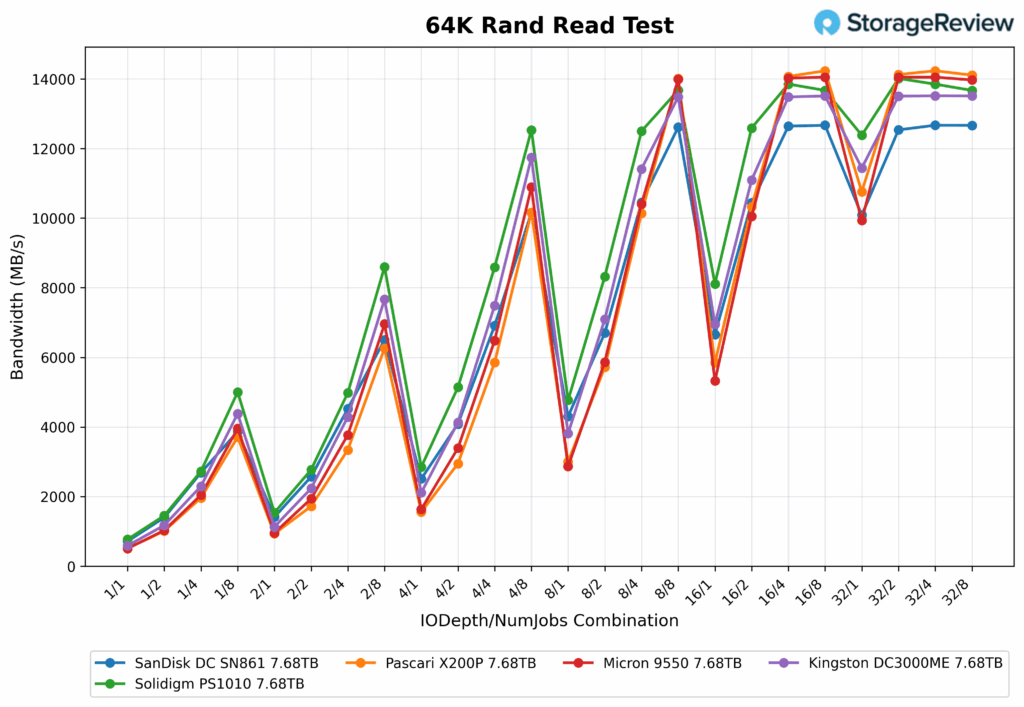
在 64K 隨機讀取測試中,金士頓 DC3000ME 在整個 IOdepth/NumJobs 矩陣中表現出色且性能穩定,最終位居第四(略微領先)。峰值頻寬在 13,515/32 時達到 4MB/s,在 16/4(13,482MB/s)和 32/8(13,512MB/s)時也達到了類似的高吞吐量,在高並行讀取工作負載下展現出卓越的可擴展性。在 1/4 和 2/2 等較低負載下,金士頓 DC3000ME 的測得速度分別為 2,298MB/s 和 2,234MB/s。
64K隨機讀取延遲
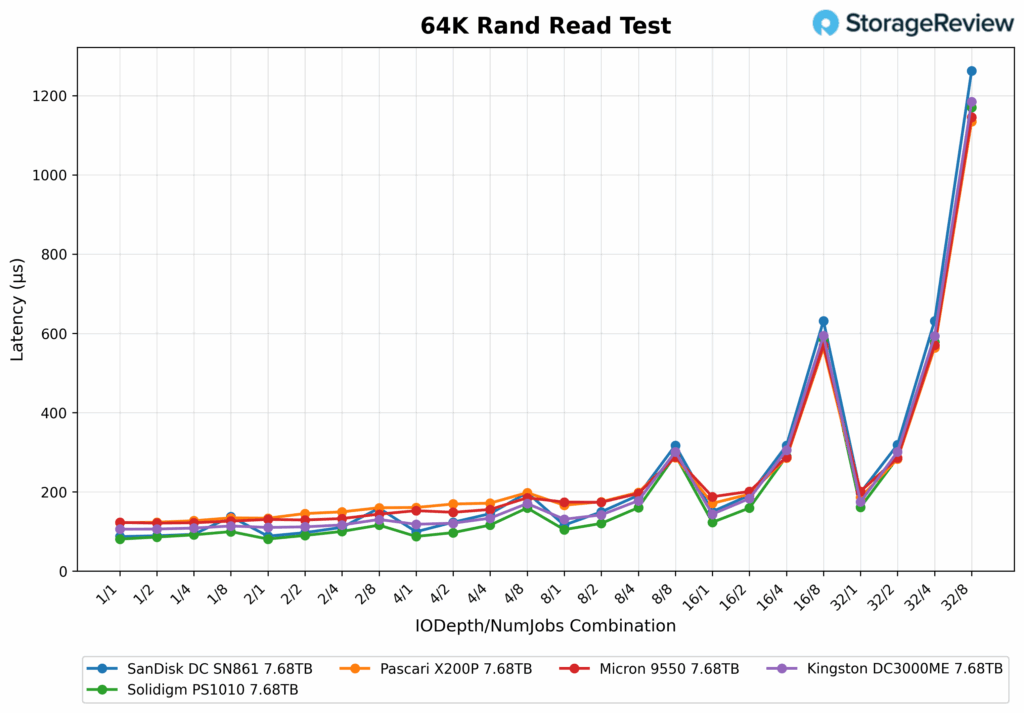
金士頓 DC3000ME 64K 延遲在所有測試點都保持相對較低。所有硬碟的表現都相似,儘管閃迪 SN861 在測試結束時的峰值明顯高於所有其他測試硬碟。從 1/2 開始,金士頓 DC3000ME 的延遲為 106µs,108/1 時為 4µs,131/8 時為 1µs,133/4 時為 4µs,177/8 時為 4µs。在更高的同時度下,延遲在 305/16 時增加到 4µs,174/32 時為 1µs,301/32 時為 2µs,並在 1,184/32 時達到峰值 8µs,與同類產品持平。總體而言,金士頓 DC3000ME 的延遲曲線與頂級產品非常接近,抖動或異常峰值極小(所有測試的驅動器都是這種情況)
16K 隨機寫入
在 16K 隨機寫入測試中,金士頓 DC3000ME 在所有隊列深度和線程數範圍內均展現出強勁的頻寬,最終在競品硬碟中位居第二。在 427,592/32 配置下,其最高 IOPS 達到了 16。其他優異表現包括 338,521/32 配置下的 8 IOPS、251,428/16 配置下的 4 IOPS 以及 226,606/1 配置下的 8 IOPS,這些均在不同並行負載下展現出卓越的控制器效率。即使在 2/16 和 1/4 等中等負載設定下,該硬碟也分別達到了 218,300 IOPS 和 204,867 IOPS。總體而言,金士頓 DC3000ME 在整個測試矩陣中(除少數區域外)始終保持 160,000 以上的 IOPS,使其成為此類工作負載下性能較為均衡的硬碟之一。
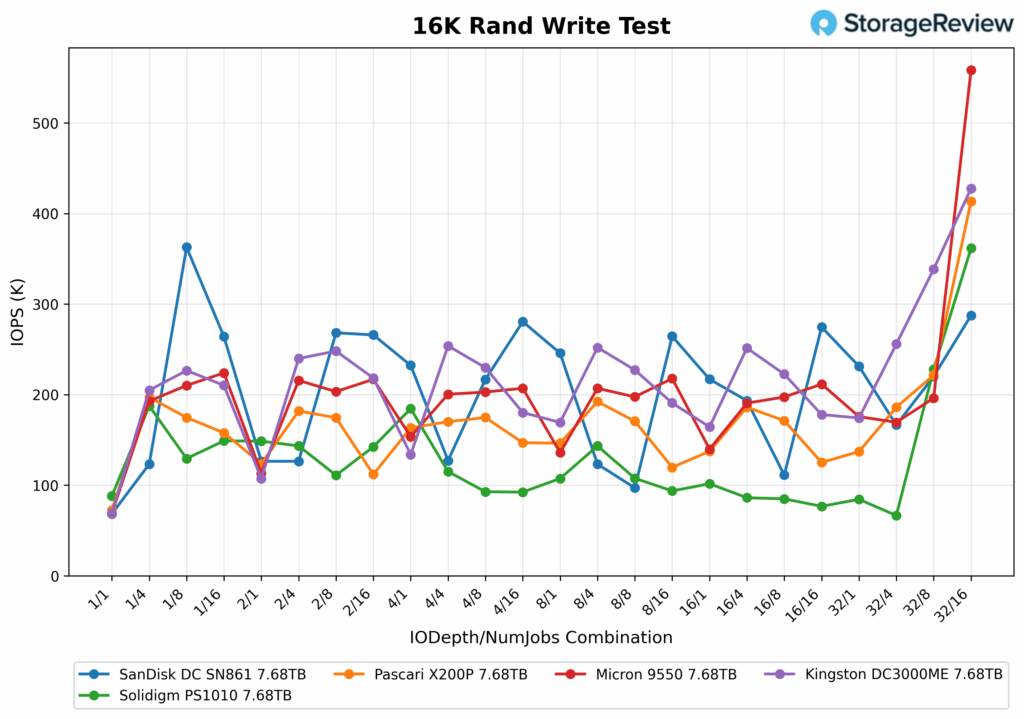
16K隨機寫入延遲
金士頓 DC3000ME 16K 寫入延遲效能非常穩定,在測試結束時位居榜首(Pascari 硬碟以微弱差距落後)。金士頓 DC3000ME 的亮點包括:14/1 倍速時 1µs,18/2 倍速時 1µs,19/1 倍速時 4µs,29/1 倍速時 2µs。隨著負載增加,金士頓保持了良好的延遲曲線:126/8 倍速時 4µs,146/2 倍速時 16µs,254/16 倍速時 4µs,575/16 倍速時 8µs。即使在最重的配置 32/16 下,延遲也保持在 1,197µs 的範圍內。
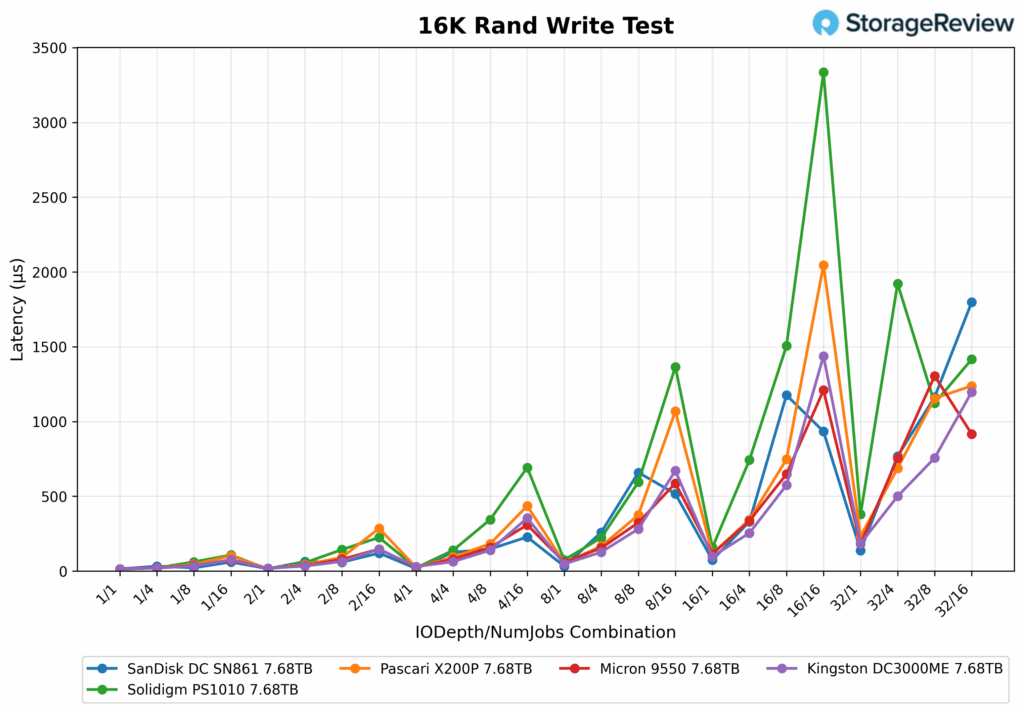
16K隨機讀取
在16K隨機讀取條件下,金士頓DC3000ME一直保持著強勁的性能,直到達到8/8時才開始略微落後。峰值IOPS在QD800(648,686個作業)下略低於32K(641),其次是QD4(16個作業)下的623K IOPS,以及QD16(3000個作業)下的XNUMXK IOPS。可惜的是,金士頓DCXNUMXME最終與閃迪SanDisk硬碟一起,在排行榜上墊底。
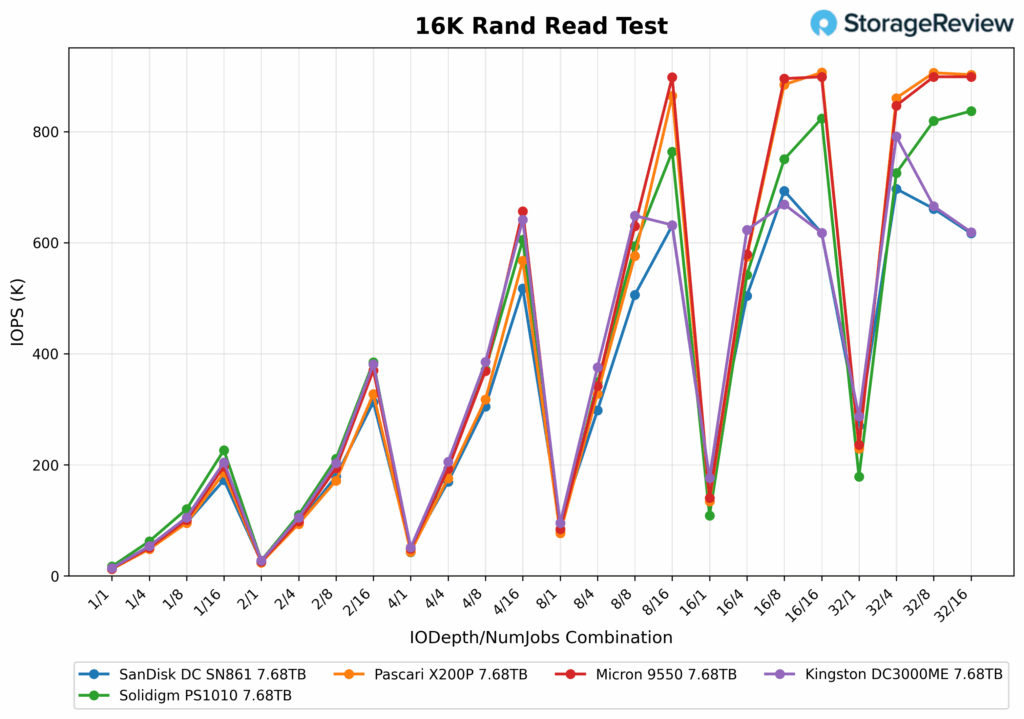
16K隨機讀取延遲
在峰值吞吐量(QD8/8)下,金士頓 DC3000ME 的延遲僅為 99µs,並且在大多數配置下都保持在一個較窄的低延遲範圍內,直到 16/8 左右才開始出現問題。在 QD1/4 下觀察到最佳延遲(74µs),在低到中等隊列深度下也觀察到了其他低於 80µs 的結果。在 QD32/16 等更重的負載下,金士頓 DC3000ME 的延遲為 826µs,明顯高於其他測試的硬碟(SanDisk 除外)。
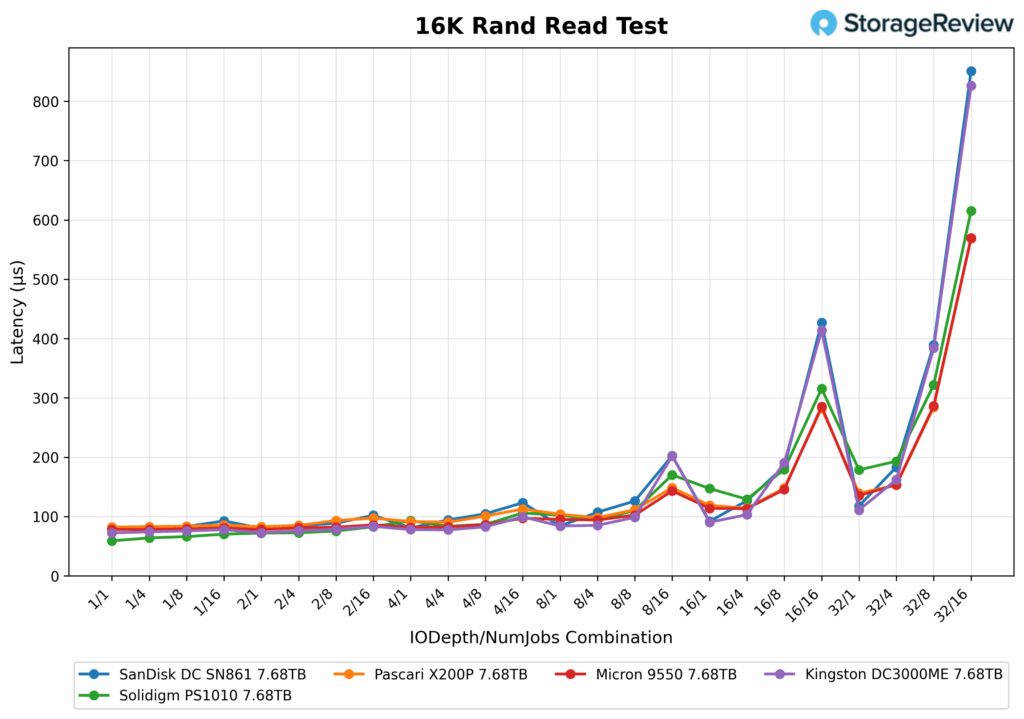
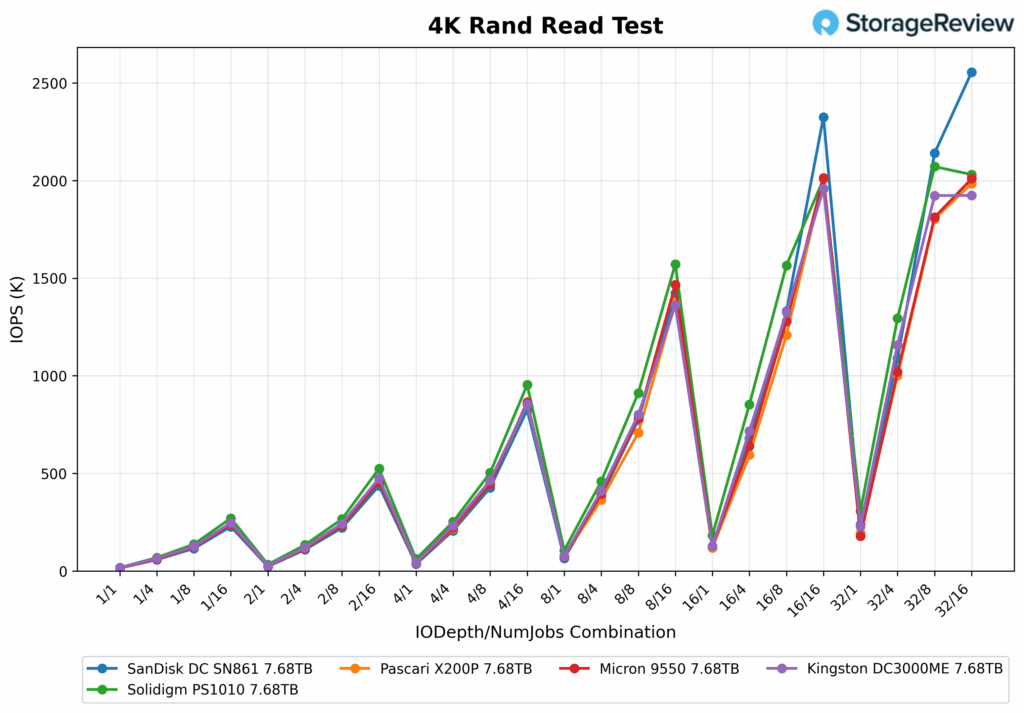
4K 隨機讀取
在 4K 隨機讀取測試中,金士頓 DC3000ME 在整個測試範圍內表現出色,在 1,957.92/16 配置下峰值達到 16K IOPS。它在 1,923.42/32 配置下保持了 8K IOPS 的高吞吐量,在 1,361.32/8 配置下為 16K IOPS,在 1326.03/16 配置下為 8K IOPS,與 Solidigm 和美光一起持續位居榜首。
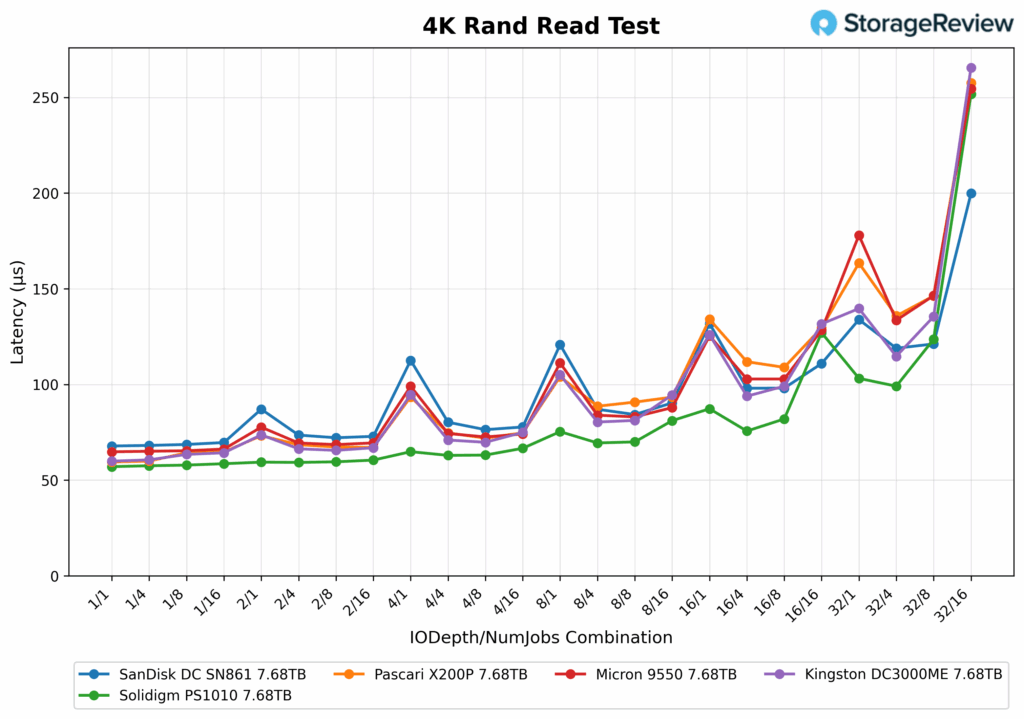
 4K隨機讀取延遲
 4K隨機讀取延遲
金士頓 DC3000ME 在整個 4K 隨機讀取測試中保持低延遲,在 60/1 配置下最低為 1µs。在 1/4 配置下,延遲略有提升至 61µs,在 1/8 配置下則穩定在 63µs。隨著並發性的增加,金士頓 DC3000ME 的延遲呈現可預測的上升趨勢:66/2 配置下為 4µs,67/2 配置下為 16µs,71/4 配置下為 4µs,80/8 配置下為 4µs。在更高配置下,延遲略有上升:94/16 配置下為 4µs,99/16 配置下為 8µs,135/32 配置下為 8µs,266/32 配置下則達到峰值 16µs。
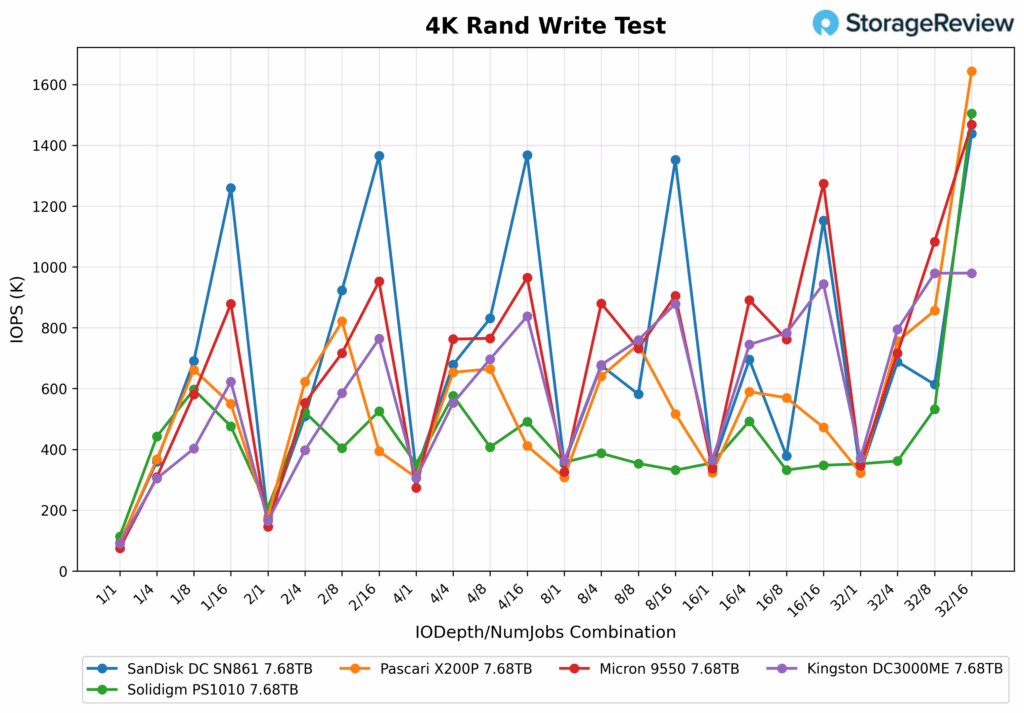
4K 隨機寫入
在4K隨機寫入方面,金士頓DC3000ME表現強勁,在979,636/32倍速下最高可達16 IOPS,在979.173/32倍速下最高可達8 IOPS,遠遜於表現最佳的Pascari X200P,後者峰值超過1.6萬IOPS。即便如此,金士頓DC3000ME在中等負載下的表現也相當不錯,例如在879/8倍速下為16K IOPS,在944/16倍速下為16K IOPS,在745/16倍速下為4K IOPS。
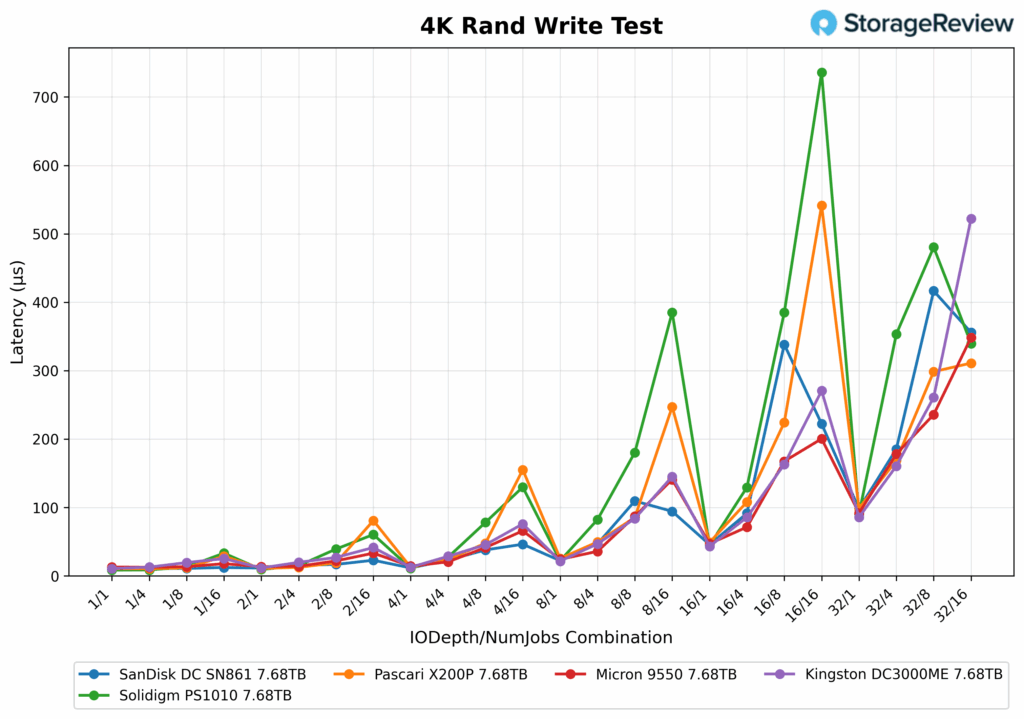
4K隨機寫入延遲
在隨機寫入延遲方面,金士頓 DC3000ME 在 11/1 深度下起始延遲為 1µs,在達到 20/50 深度之前保持在 8-8µs 左右,在 261/32 深度下擴展至 8µs,在 522/32 深度下擴展至 16µs。雖然延遲並非最低,但金士頓 DC3000ME 保持了可預測且適度的擴展,沒有像 Solidigm 和 Pasarci 等驅動器那樣出現峰值,而後者在超過 16 個線程後波動較大。
GPU直接儲存
我們在這個測試台上進行的測試之一是 Magnum IO GPU 直接儲存 (GDS) 測試。 GDS 是 NVIDIA 開發的功能,可讓 GPU 在存取儲存在 NVMe 磁碟機或其他高速儲存裝置上的資料時繞過 CPU。 GDS 不再透過 CPU 和系統記憶體來路由數據,而是實現了 GPU 和儲存設備之間的直接通信,從而顯著減少了延遲並提高了數據吞吐量。
GPU 直接儲存的工作原理
傳統上,當 GPU 處理儲存在 NVMe 磁碟機上的資料時,資料必須先經過 CPU 和系統內存,然後才能到達 GPU。此過程會引入瓶頸,因為 CPU 成為中間人,增加延遲並消耗寶貴的系統資源。 GPU 直接儲存使 GPU 能夠透過 PCIe 總線直接從儲存裝置存取數據,從而消除了這種低效率。這種直接路徑減少了與資料移動相關的開銷,從而實現更快、更有效率的資料傳輸。
人工智慧工作負載,尤其是涉及深度學習的工作負載,是高度資料密集的。訓練大型神經網路需要處理 TB 級的數據,資料傳輸中的任何延遲都可能導致 GPU 利用率不足和訓練時間更長。 GPU 直接儲存透過確保資料盡快傳輸到 GPU、最大限度地減少空閒時間並最大限度地提高運算效率來解決這一挑戰。
此外,GDS 對於涉及串流大型資料集的工作負載特別有利,例如視訊處理、自然語言處理或即時推理。透過減少對 CPU 的依賴,GDS 可以加速資料移動並釋放 CPU 資源用於其他任務,從而進一步增強整體系統效能。
讀取吞吐量
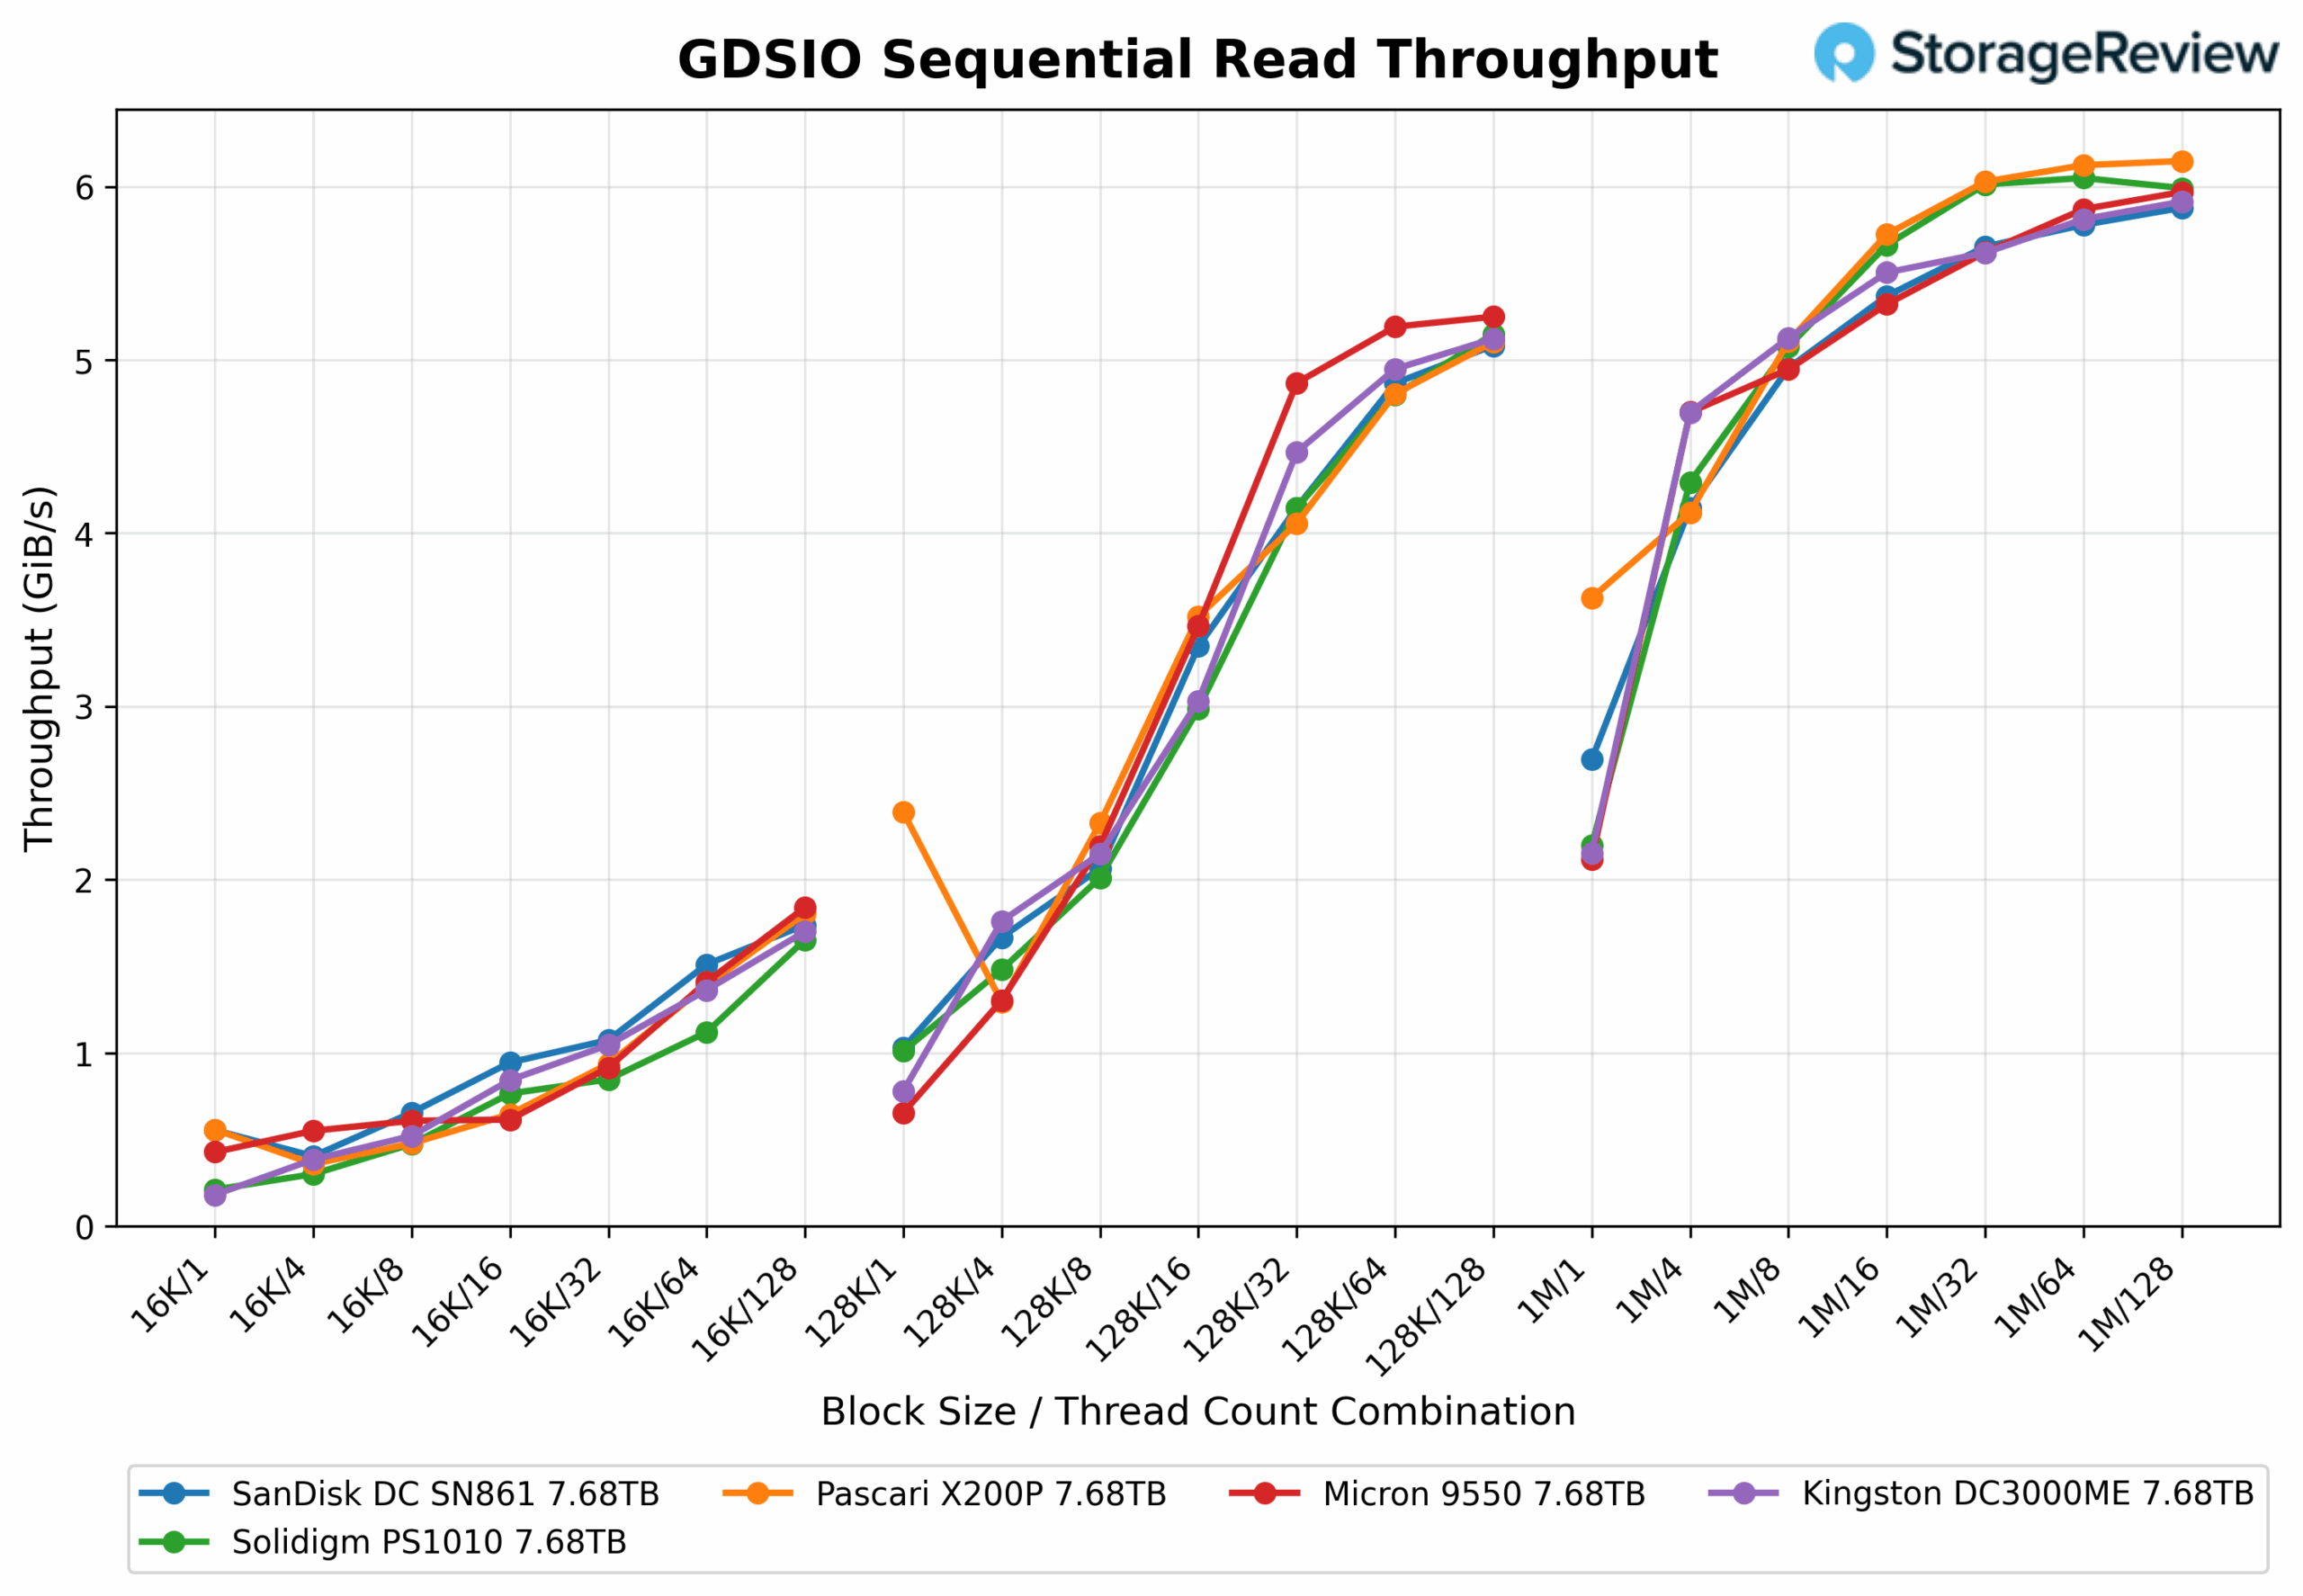
在我們的 GDSIO 順序讀取測試中,金士頓 DC3000ME 在 16K、128K 和 1MB 區塊大小下均展現出一致高效的吞吐量擴展,但效能趨勢會因傳輸大小而略有不同。在 16K 區塊大小下,吞吐量隨著執行緒數的增加而穩定上升,金士頓 DC3000ME 在 3.70 個執行緒時達到峰值 32GiB/s,然後在 3.41 個執行緒時逐漸下降至 128GiB/s。對於 128K 傳輸,該驅動器在 5.88 個執行緒時達到了 16GiB/s 的最佳結果,並在 32 個執行緒時保持該水平,然後在 5.35 個執行緒時下降至 128GiB/s 左右。在 1MB 大小下,金士頓 DC3000ME 吞吐量較早達到穩定狀態,在 6.54 個線程時達到 16GiB/s,在 5.91 個線程時略微下降至 128GiB/s。
閱讀延遲
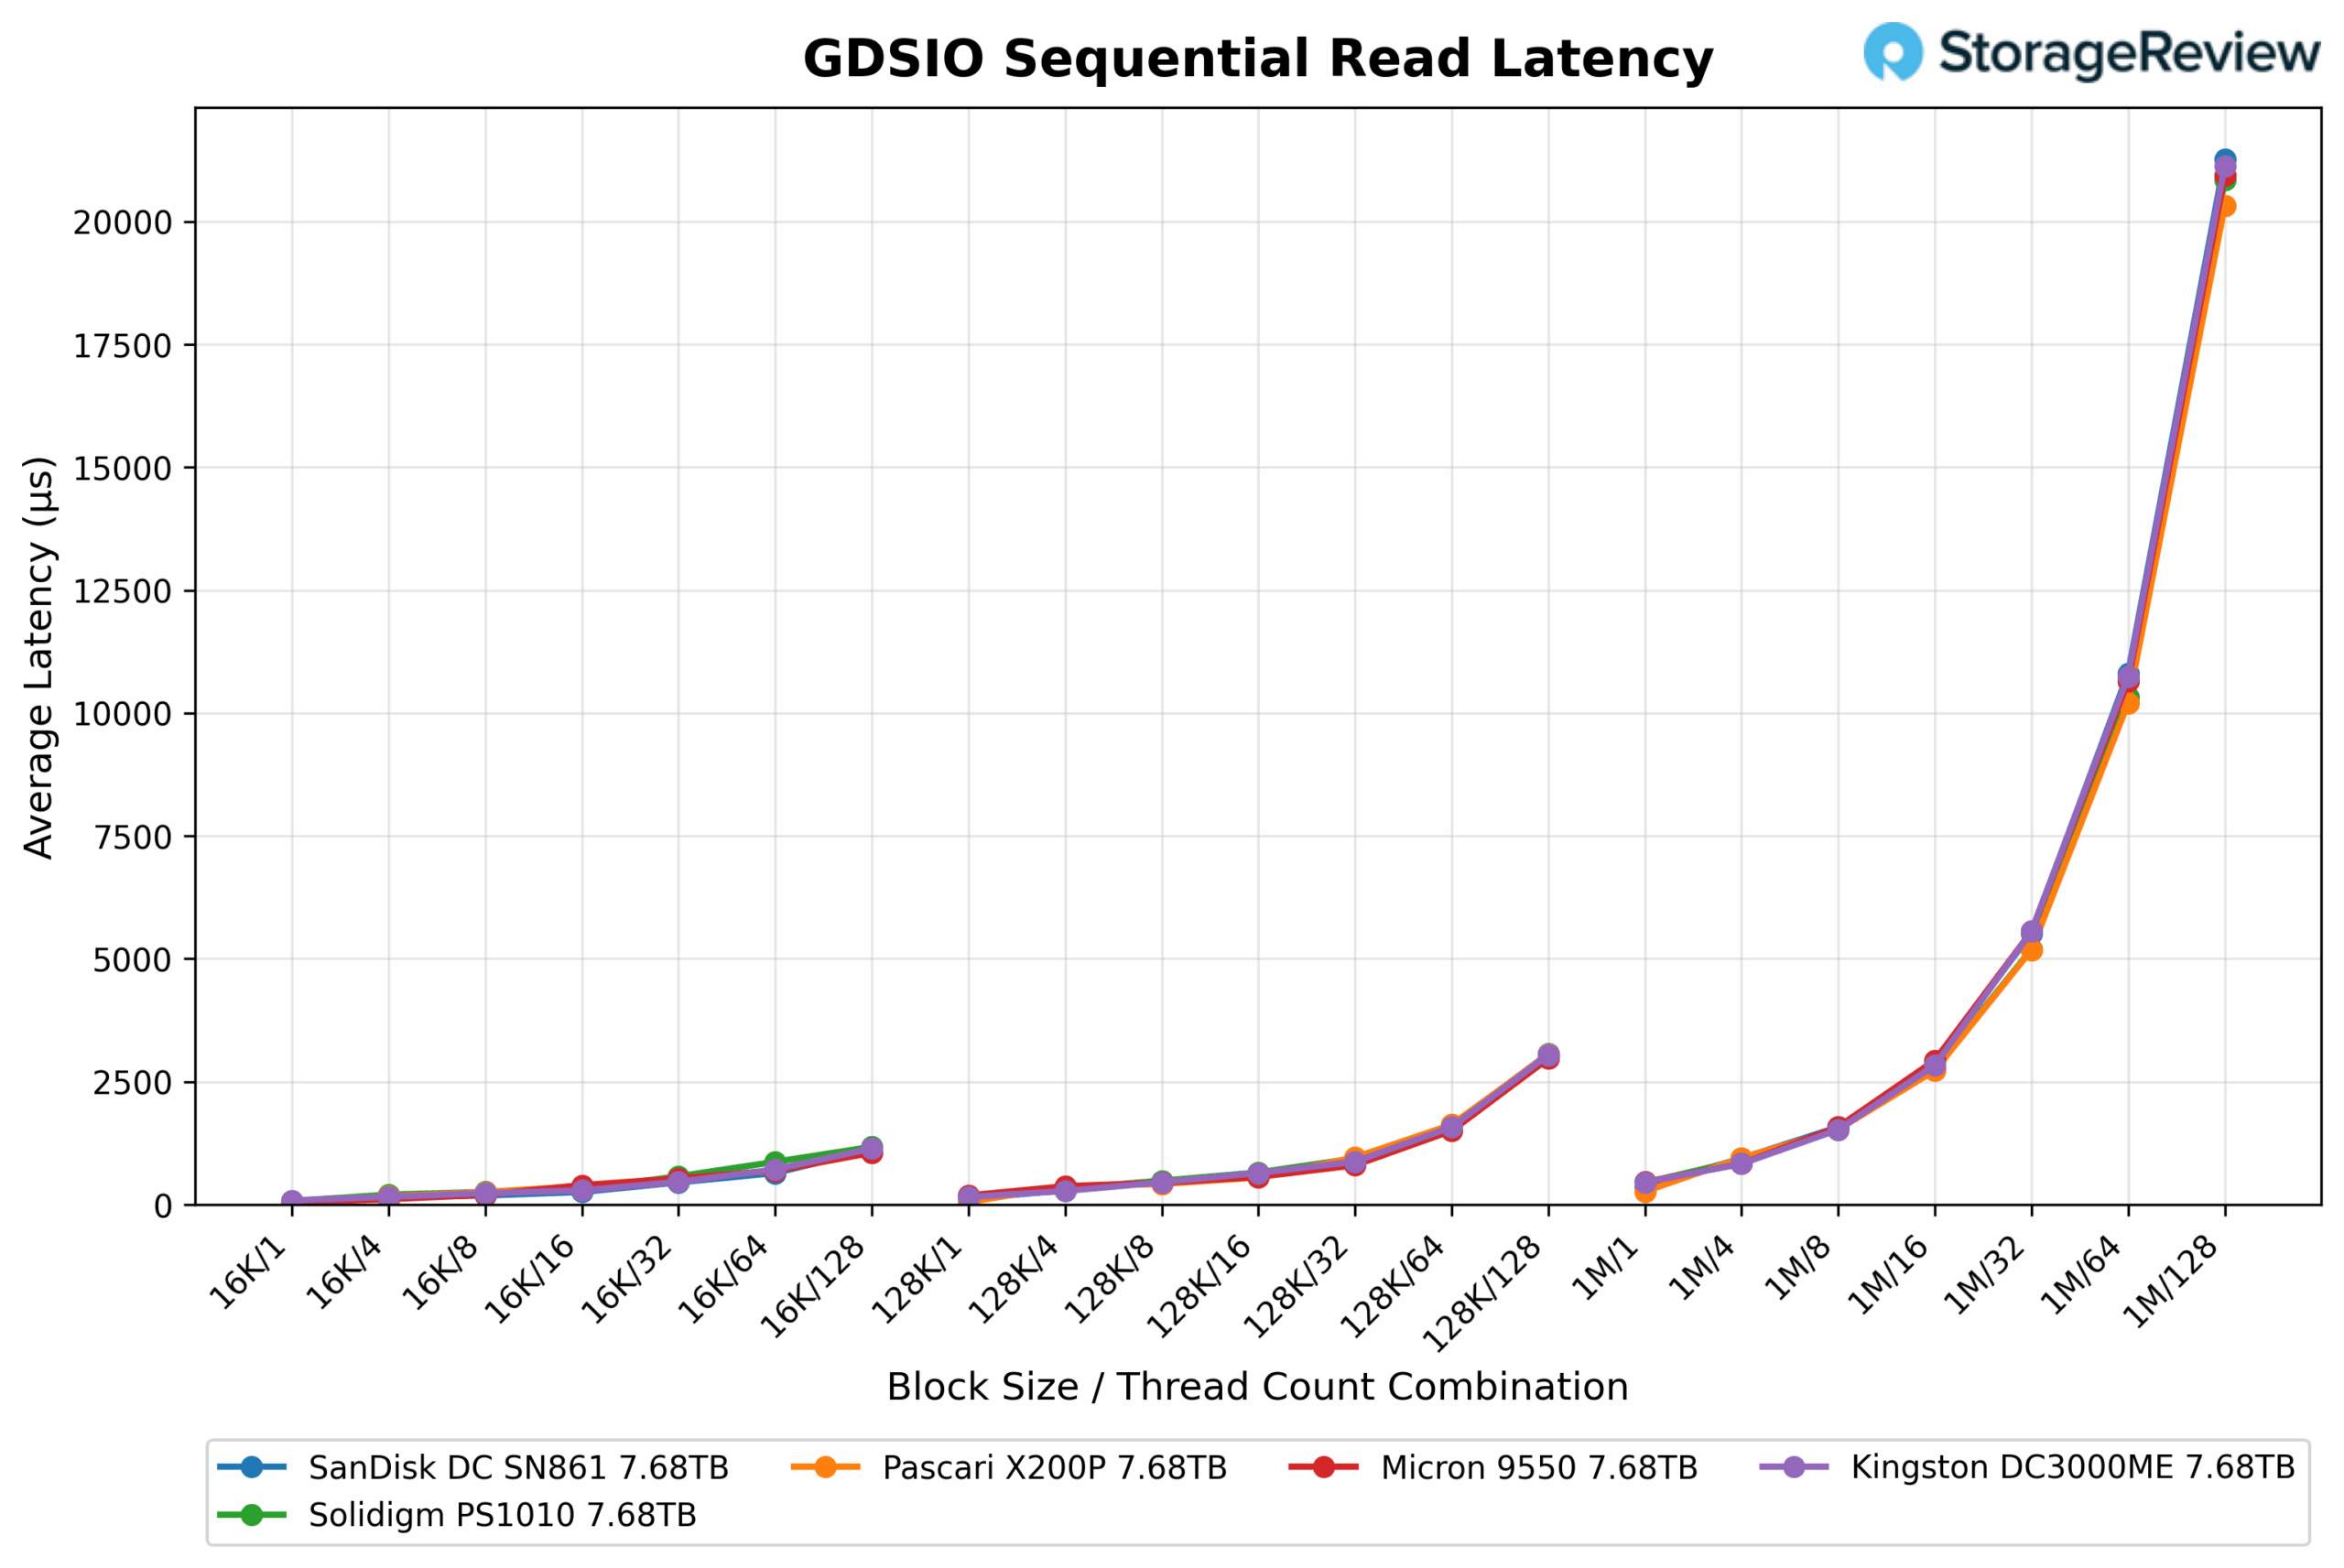
在延遲方面,DC3000ME 表現出可預測的擴展性(所有測試的硬碟都是如此):較低的線程數在所有區塊大小上都產生了較短的響應時間,並且隨著線程數的增加,延遲會增加。在 16K 時,延遲從 504µs 開始,到 582 個線程時逐漸增加到 128µs。在 128K 時,金士頓 DC3000ME 的延遲從 2,60µs 開始,在最高線程數時增加到 3,228µs。在 1MB 區塊大小下,由於負載較大,延遲出現了更大的躍升,從單線程時的 2,609µs 開始,到 2,703 個線程時增加到 128µs。
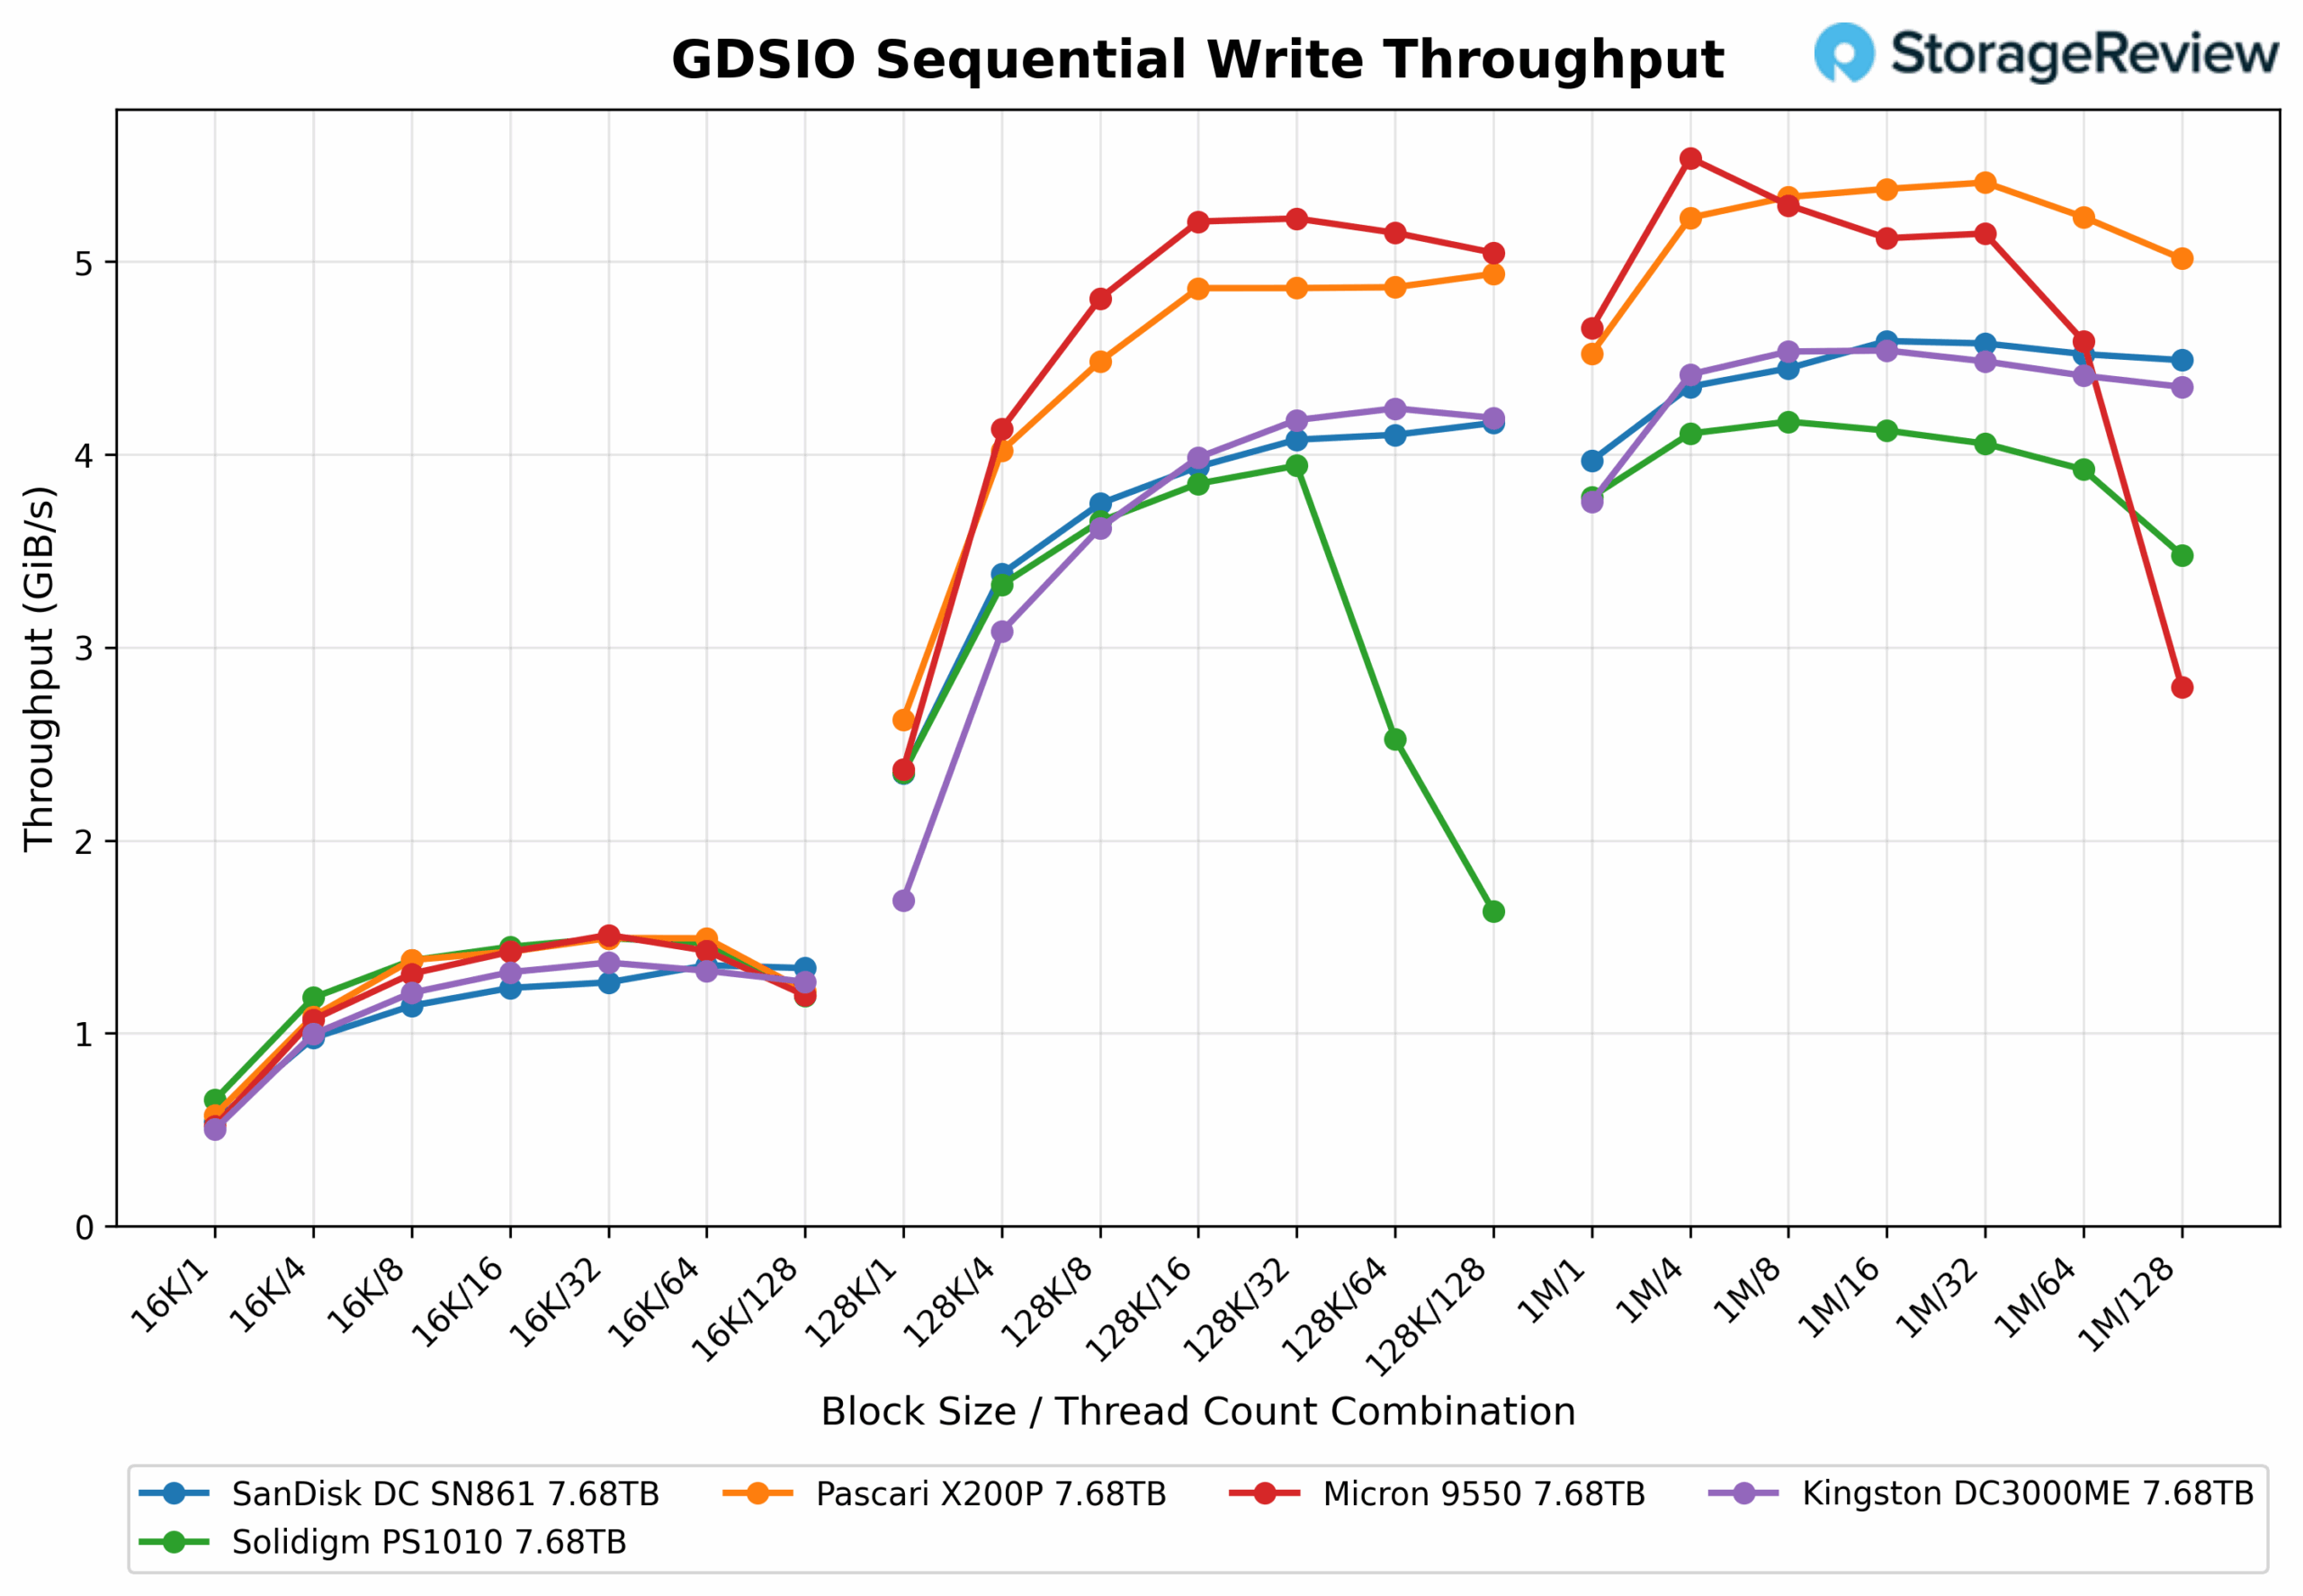
寫吞吐量
對於讀取操作,16K 區塊的平均延遲在單線程下初始為 2,247µs,在 504 線程下下降至 128µs,展現了並發環境下的高效擴展能力。對於 128K 區塊大小,延遲初始為 4,035µs,在 2,601 線程下逐漸下降至 128µs。對於 1M 區塊,金士頓 DC3000ME 的整體延遲最低,在單線程下初始為 2,609µs,在 2,500 線程下保持在 2,700-128µs 範圍內,展現了對大規模順序讀取的一致響應能力。
寫入延遲
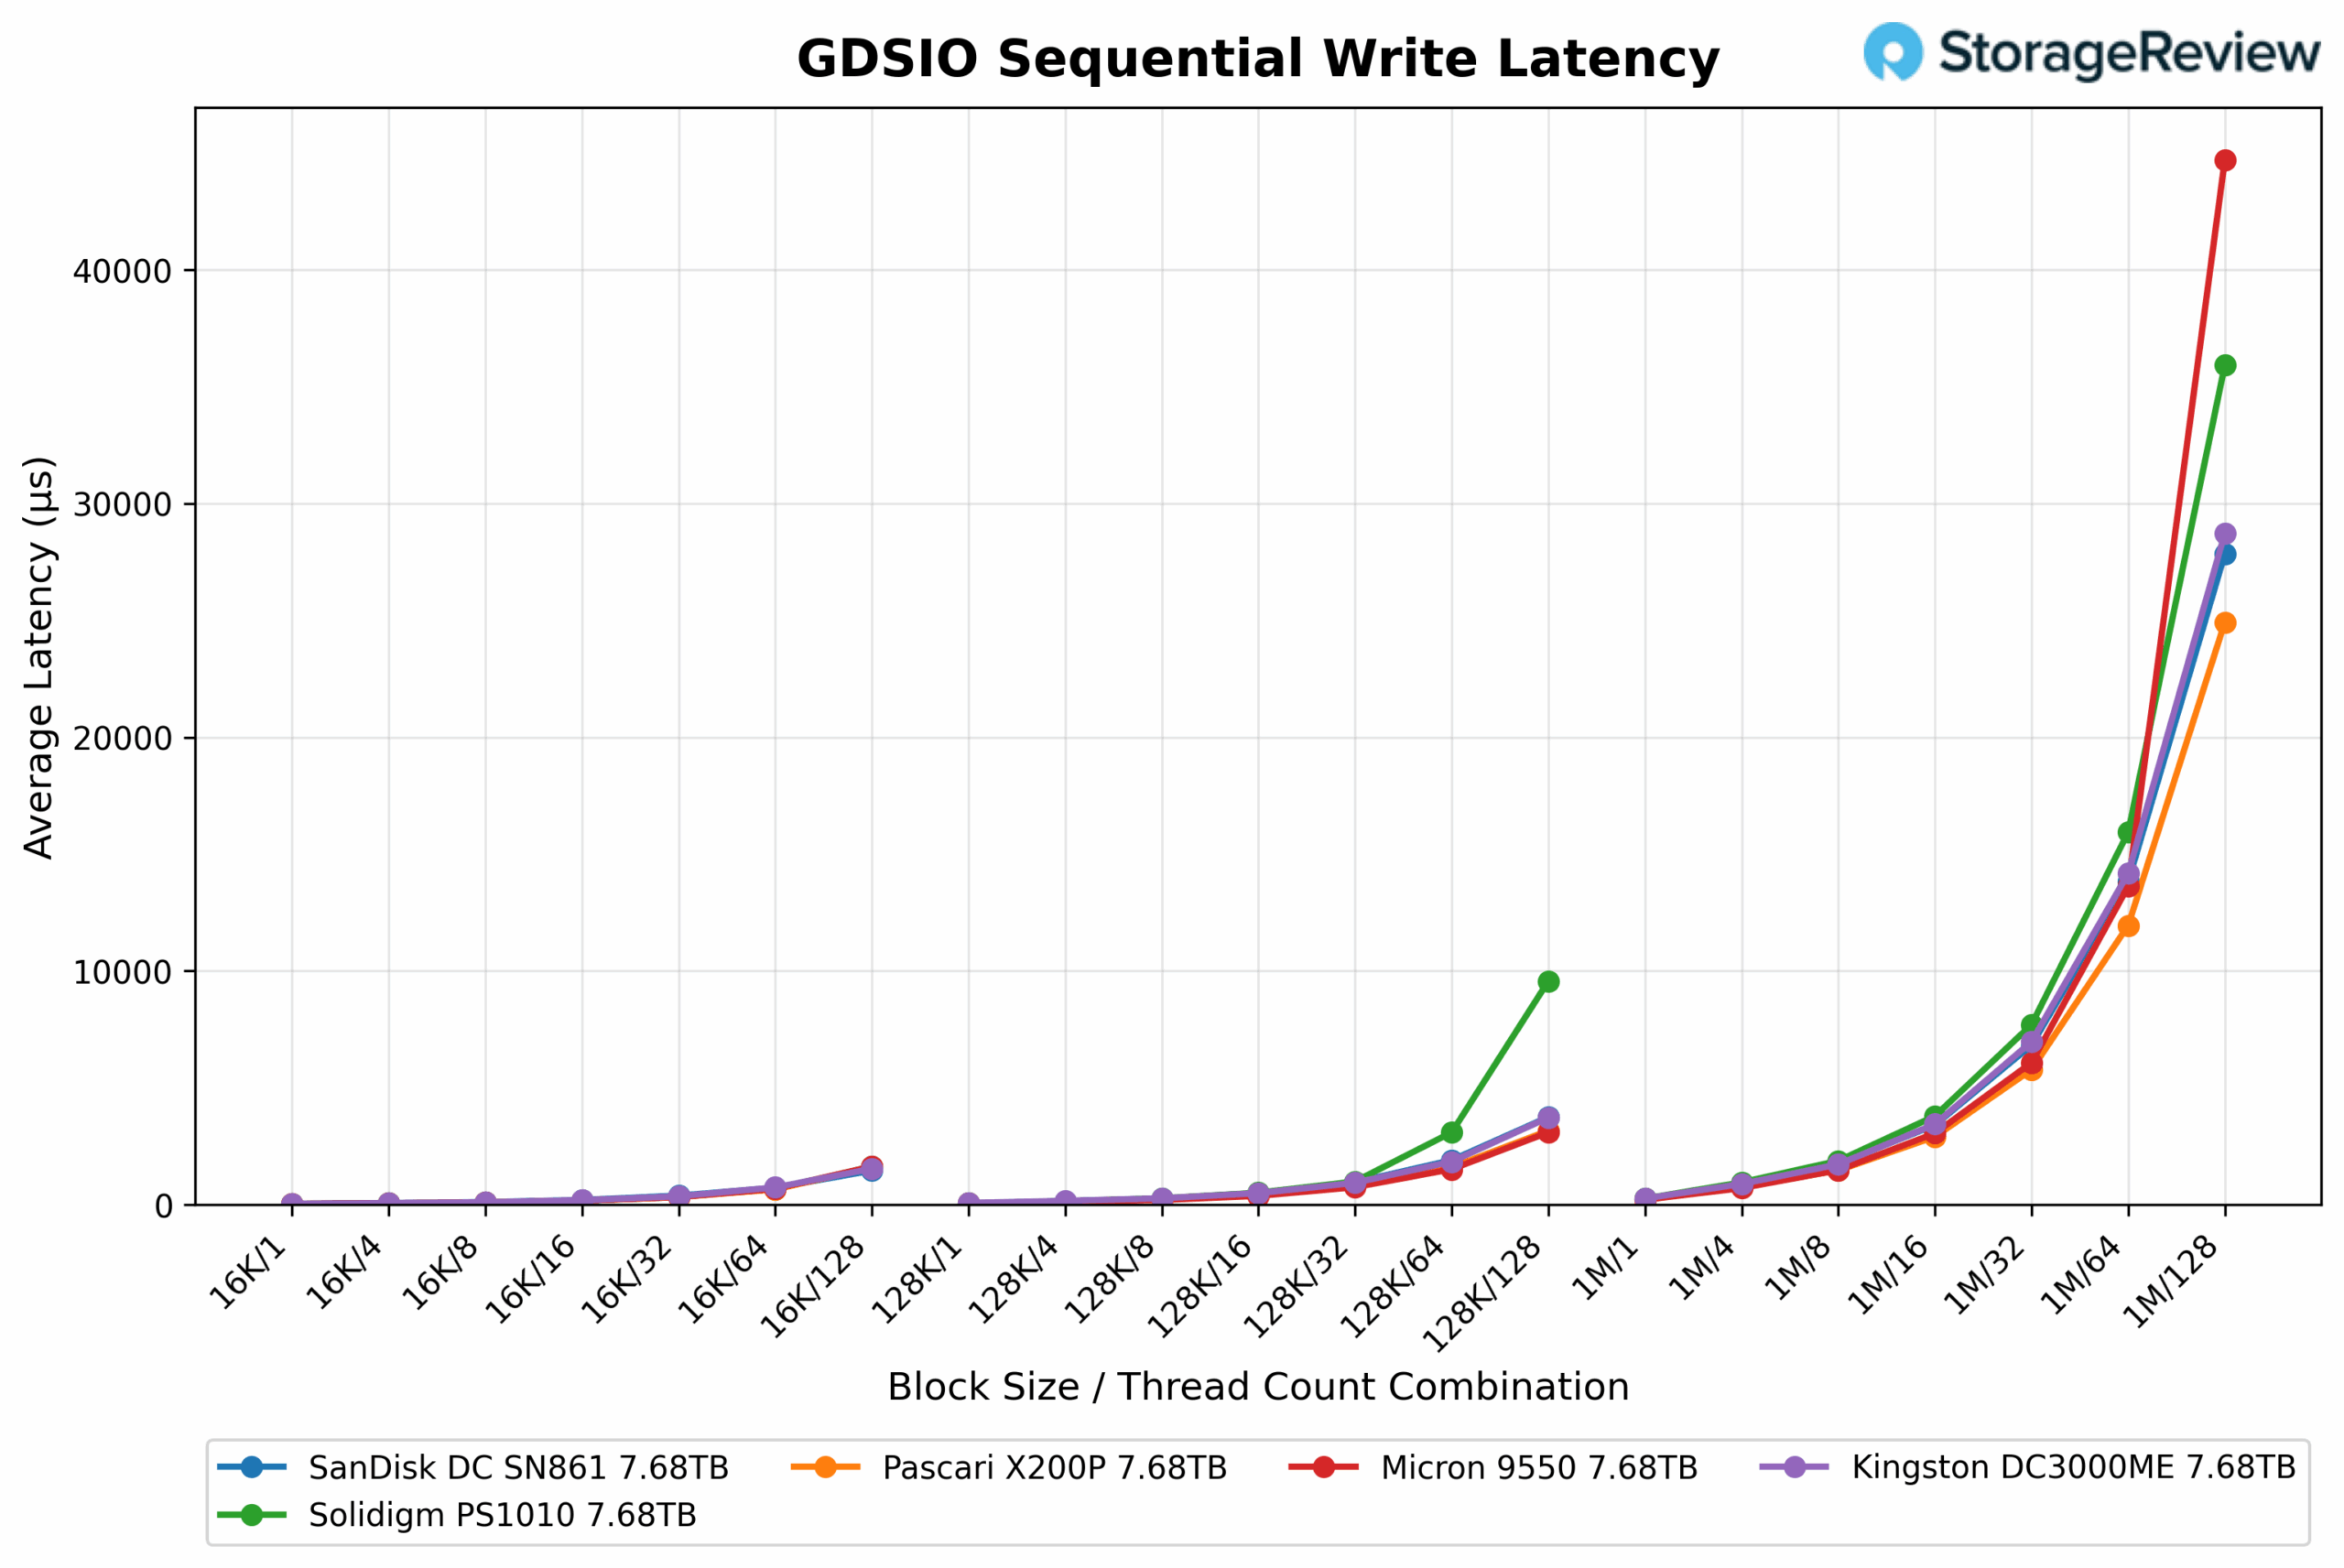
線程數從1到16個線程,平均延遲保持相對穩定,徘徊在12,234到14,247微秒之間。在32個執行緒時,延遲略微上升至15,559微秒,在20,944個執行緒時則攀升至64微秒。在128個線程時,金士頓DC3000ME的延遲出現了顯著的峰值,躍升至28,725微秒,是之前的兩倍多。
結語
金士頓 DC3000ME 定位為主流企業和資料中心部署的實用解決方案,可靠性、穩定的效能和強大的企業級功能是這些部署的關鍵要求。這款硬碟可滿足系統整合商、加值經銷商 (VAR) 以及中小企業 (SMB) 環境中建置和管理其基礎架構的 IT 團隊的需求。其 U.2 尺寸規格和 PCIe Gen5 支援提供了廣泛的兼容性和麵向未來的頻寬,使其成為通路驅動型部署的有力候選者。
從效能角度來看,DC3000ME 在各種工作負載下都能提供極具競爭力的吞吐量和效率。其優勢在於穩定的順序讀取、良好的寫入一致性以及在混合和隨機工作負載下持續的延遲擴展。雖然在某些高負載 CDN 或檢查點基準測試中,它偶爾會落後於美光和閃迪等頂級第五代儲存產品,但它仍然保持著競爭力,尤其是在持續的混合負載場景和中等並發性的情況下。
整體而言,DC3000ME 非常適合通用企業工作負載,能夠滿足那些希望部署高效能儲存而無需依賴高度客製化的 OEM 解決方案的企業的需求。增值轉售商 (VAR) 和系統建置商會發現它有很多值得稱道的地方,尤其是在實際基礎設施部署中平衡成本、效能和可擴展性時。


 Amazon